“规模法则”的版本间的差异
(→空间幂律) |
(→规模法则) |
||
| 第1,699行: | 第1,699行: | ||
=====规模法则===== | =====规模法则===== | ||
| − | + | 进一步,我们对上述累积分布规律对半径 [math]r[/math] 做积分,就可以求出一座城市中活跃人口、道路长度和社会经济互动的总量,这些总量仅与城市的半径大小有关,且呈现幂律关系: | |
:<math> | :<math> | ||
| 第1,705行: | 第1,705行: | ||
</math> | </math> | ||
| − | 这里的[math]Y[/math]可以代表城市中的总人口、总道路长度,或城市中的总的社会经济互动(即GDP),[math]R[/math]为城市的半径,[math]\eta[/math]为与[math]\beta[/math] | + | 这里的[math]Y[/math] 可以代表城市中的总人口、总道路长度,或城市中的总的社会经济互动(即GDP),[math]R[/math]为城市的半径,[math]\eta[/math]为与[math]\beta[/math]无关的幂指数。当 [math]Y[/math] 分别代表人口、道路和GDP的时候,这三个幂指数分别为:1,1/2,和3/2。由此我们可以消去 [math]R[/math],而将所有的 [math]Y[/math] 表达为人口 [math]N[/math] 的函数,可以得到如下幂律关系: |
:<math> | :<math> | ||
| 第1,711行: | 第1,711行: | ||
</math> | </math> | ||
| − | + | 这里的 [math]X[/math]可以代表城市的面积、道路总长度、GDP等指标,幂律指数 [math]\gamma[/math] 会因指标的变动而变,我们可以总结为下表: | |
{| class="wikitable" | {| class="wikitable" | ||
2026年1月21日 (三) 15:52的版本
规模法则(Scaling Law),又称标度定律,或简称标度律,是描述复杂系统中各种可测量特性如何随系统规模发生系统性地、可预测变化的数学关系。这些数学关系通常表现为幂律的形式,它们能够反映从生命体到城市、企业乃至人工智能大模型等复杂系统在规模缩放过程中展现出的结构、功能和动态行为上的普遍性规律。根据维斯特(G. West)的规模理论,规模法则不仅是一种普遍的实证规律,它更是预测复杂系统的生长与死亡的基础原则;透过规模法则,人们还可以构建复杂系统的网络模型,以解释、重构各类实证观察现象,同时推断复杂系统的结构与功能之间的关系,甚至有助于系统的优化与设计。
规模法则一般表现为如下的幂律形式:
-
[math]\displaystyle{ Y=cX^{\alpha}, }[/math]
(1)
其中[math]X[/math]通常代表一个系统的规模,例如生物体的体重,城市的人口,企业的员工数等;[math]Y[/math]则代表系统的某一种可测量的宏观变量,例如生物体的新陈代谢率、城市的GDP,以及企业的总收入等;[math]c[/math]为规模法则的系数,它代表了规模缩放的基底,即系统规模为1的时候,[math]Y[/math]是多少;[math]\alpha[/math]为规模法则的幂指数,是规模法则的重要参数,刻画了[math]Y[/math]与[math]X[/math]的相对变化速度。根据指数[math]\alpha[/math]大小的不同,我们通常将规模法则划分为三种类型:
- 当[math]\alpha>1[/math]
规模法则1称为超线性的(Super-linear)规模法则,这体现为[math]Y[/math]比[math]X[/math]增长得更快;
- 当[math]\alpha<1[/math]
规模法则1称为亚线性的(Sub-linear)规模法则,这体现为[math]Y[/math]比[math]X[/math]增长得更慢;
- 当[math]\alpha\approx 1[/math]
规模法则1称为线性的(Linear)规模法则,这体现为[math]Y[/math]与[math]X[/math]成比例。
规模分析简史
规模法则最早来源于规模分析(Scaling Analysis)方法,也译为标度分析、尺度分析。这是一种通过比较一个事物的不同物理量随尺度缩放变化的大致定量关系来揭示自然界普遍规律的方法。它不仅在物理学和工程学中存在着广泛应用,也是理解生物、社会和复杂系统的重要工具。这一思想可以追溯到伽利略,并在后来的科学发展中不断演进,逐渐形成了我们今天所称的“规模法则”(Scaling Laws)。几种典型的规模分析方法应用实例如下。
伽利略的规模缩放理论
伽利略(Galileo Galilei)在《关于两种新科学的对话与数学证明》[1]中首次系统性提出了规模缩放的思想:如果一个物体按照几何比例放大,那么其力学性质不会简单地按比例的方式扩展,而是呈现出了一定的非线性的缩放规律[2] 。例如:
面积与体积的幂律关系
假设一个立方体边长为 [math]L[/math]:那么其表面积 [math]A \propto L^2[/math],体积 [math]V \propto L^3[/math]。这里符号“[math]\propto[/math]”代表“成比例于”后面的变量,这是对幂律关系的一种简约的表达,即忽略了前面的系数,而只关注于幂律指数。
因此,当边长增大一倍时:面积只增加 [math]2^2 = 4[/math] 倍,体积却增加 [math]2^3 = 8[/math] 倍。因此,当一个几何体生长的时候,它的体积会比表面积增长得更快。
强度与重量
几何体的横截面积[math]A[/math]往往也随着物体的长度而呈现2次方增长关系。进一步,支撑物体的应力强度[math]S[/math]通常也正比于横截面面积,因此 [math]S \propto A \propto L^2[/math];而物体重量 [math]W \propto V \propto L^3[/math]。
伽利略根据这一几何关系指出:在放大过程中,物体体积(重量)增长速度快于面积(支撑力),这意味着随着体型增大,每单位体重的应力强度,即[math]S/V[/math]会降低,这一结论具有许多现实的意义,例如,大型生物体必须演化出更加粗壮的大腿,才能够支撑它们庞大的体重。正因如此,老鼠的腿细长而灵活,而大象的腿却像柱子一般粗壮。伽利略甚至打趣道:“一只小狗能背两三只与它体型相当的小狗,但一匹马却驮不起一匹与自身一样大小的马”。另外,我们在地球表面很难观察到比长颈鹿或大象更大型的动物,海洋里反而存在着体积更大的动物,如鲸,这是因为海水的浮力可以对抗鲸类巨大的体重。这些直观的自然现象,都是规模缩放规律的推论。
同样的,强度与重量的缩放规模也可以用来指导我们进行工程设计,例如:桥梁与高塔要想建得更高就必须加粗支撑柱。
异速生长
在伽利略根据几何和力学规律,发现了生物体身上的一系列规模法则之后,人们进一步针对更广泛的生物学量发现了与生物体尺寸(体重或身长)的规模法则(幂律关系),并将这些规律命名为异速生长标度律(Allometric Scaling Law),或简称异速生长(Allometry)。
异速生长 (Allometry )是关于身体大小与形状[3]、解剖学、生理学以及人类行为[4]间关系的研究,于1892年被 Otto Snell[5] ,1917年被 D'Arcy Thompson[6] 和1932年被 Julian Sorell Huxley[7] 首先阐述。异速生长是个著名的研究论题,尤其在统计形状分析及活机体不同部分生长率研究的生物学上。应用之一就是在各种昆虫种类研究上,即整个身体中的某个小部位的变化,能够导致四肢附件如腿、触角等呈现巨大的不成比例的变化。
量纲分析
量纲分析(dimensional analysis)是一种只利用物理量的“量纲/单位”关系来推断公式结构、做数量级估算、检验推导是否可能出错的方法。核心思想:任何物理定律在单位变换下都应保持形式一致,因此等式两边的量纲必须相同。
量纲分析的历史大致经历了从“量纲一致性直觉”到“系统方法”的演进:17世纪经典力学兴起后,人们逐渐形成方程两边必须同类量的观念;19世纪傅里叶在热学中明确强调用量纲一致性检验推导,随后麦克斯韦等推动以基本单位幂次表示物理量、瑞利常用幂律假设做尺度推断;1914年Buckingham提出Pi定理[8],把量纲分析系统化为用无量纲群刻画物理规律的方法;20世纪在流体力学、传热与工程缩比实验中随着雷诺数、弗劳德数等无量纲数的广泛应用而成熟,并在现代与无量纲化和规模分析结合,用于建模、相似理论与数量级估算[9]。
寻找无量纲量
根据量纲分析中Buckingham的Pi定理[8]的基本思想,我们可以用量纲约束来构造无量纲量(dimensionless numbers)并把原问题降维。具体的,若有[math]n[/math]个变量、涉及[math]k[/math]个独立基本量纲,则可构造[math]n-k[/math]个独立无量纲量[math]\Pi_i[/math],使得它们满足如下的约束方程:
- [math]\displaystyle{ F(\Pi_1,\dots,\Pi_{n-k})=0. }[/math]
其中[math]F[/math]是对这[math]n-k[/math]个无量纲量的约束。无量纲量[math]\Pi_i[/math](dimensionless numbers)是由若干物理量组合成的纯数,它不依赖单位选择,能揭示不同系统在本质上的相似性。
- 例如,圆周率 [math]\pi = \frac{C}{D}[/math] 就是最简单的无量纲量的例子(这里C是周长,D是圆的直径)。
- 工程与物理中更典型的无量纲量是弗劳德数(Froude number):[math]Fr = v/\sqrt{gL}[/math],这里[math]v[/math]为船体运动的特征速度,[math]g[/math]为重力加速度,[math]L[/math]为船体的线性尺度。这个无量纲量比较了惯性力与重力的相对大小,决定了船只、波浪等运动的相似性。
在数学建模中,这种无量纲量的发现往往会对复杂问题的求解提供全新的思路,因为这些无量纲量的寻找可能揭示不同系统在本质上的相似性。系统性的寻找无量纲量的方法称为量纲分析。
规模不变量
规模不变量(scale invariants)或称标度不变量、尺度不变量,是指在“缩放变换”(把长度、时间、速度等按比例放大/缩小)下保持不变的量。因为缩放会改变有量纲量的数值,因此一个量若要保持在缩放下不变,就必须是无量纲量。但是,反过来无量纲量不一定是规模不变量。
根据公式1,当幂指数[math]\alpha=0[/math]的时候,[math]Y[/math]就是一个与规模[math]X[/math]无关的规模不变量。由此可见,规模法则1式是蕴含了规模不变量的。著名的规模不变量包括流体力学中的雷诺数,再如代谢生态学中,哺乳动物一生的心跳次数也是不随生物体体重规模而变的量。
规模分析方法
规模法则可以说起源于早期的规模分析方法。所谓的规模分析是一种用“数量级/尺度”来近似分析物理问题的方法:不求精确解,而是通过估计各项的大小,找出主导平衡(dominant balance),从而得到典型尺度、幂律关系、无量纲参数的控制作用,以及在不同极限下哪些效应可忽略。
规模分析的核心思路包括:
1、选择特征尺度:即给变量选择有代表性的尺度,包括长度[math]L[/math]、速度[math]U[/math]等;
2、做数量级估算,例如把导数项用尺度来替代,如[math]\partial/\partial x\sim 1/L[/math], [math]\partial/\partial t\sim 1/T[/math]等,这里符号[math]\sim[/math]代表的是前后两项具有相同的数量级,或“大致相当于”的意思;
3、比较并确定主导项:即比较哪一项最大,属于哪一个量级;
4、最后,得出结论,包括推出幂律关系(如确定[math]X\sim t^{1/2}[/math])。
一个具体的例子是,我们可以在不接方程的条件下,仅通过规模分析就能确定液体边界层厚度的幂律关系。
量纲分析与规模分析
量纲分析与规模分析(Scaling Analysis)是“相关但层级不同”的两类分析方法。量纲分析方法通过把问题构造为无量纲群,从而能够告诉我们“最少需要哪些无量纲量来描述问题”,但通常不能给出这些变量之间的具体函数关系。
规模分析的作用则是在给定方程/机制后,通过数量级估算出哪些项是主导,它们如何随尺度而变化,从而得到幂律关系(即规模法则)、相似解的指数、边界层的厚度等近似规律。
因此,通常在面临具体问题的时候,我们先根据量纲分析把问题无量纲化,然后再利用规模分析方法找到各个变量的幂律关系。
规模法则基本介绍
接下来,本词条首先介绍规模法则的一些基本概念,其次,分别针对生命系统、城市和企业这三类典型的复杂系统,介绍各自重要的规模法则。由于规模法则普遍存在,所以即使每一个具体的复杂系统中也存在着大量的规模法则,逐一介绍显得千篇一律,因此根据韦斯特的规模理论,本词条重点关注每一个系统中与新陈代谢有关的宏观变量的规模法则,这类规模法则对于理解复杂系统的生长、代谢、死亡等重要功能起到了至关重要的作用。
基本概念
非线性幂律关系
从伽利略时代起,人们就发现自然中的规模法则常常遵循幂律关系(power law)而非是线性(Linear)比例关系。
幂律关系的一般形式如公式1所示。如果我们忽略规模法则的系数,则1也可以简写为:
- [math]\displaystyle{ Y \propto X^{\alpha} }[/math]
其中,“[math]\propto[/math]”表示的是“成比例于”。式子中仅包含幂律指数[math]\alpha[/math]这一唯一的重要变量,它决定了变量之间的非线性关系。若 [math]\alpha = 1[/math],则该关系呈线性;若 [math]\alpha \neq 1[/math],则为非线性幂律关系 [2],我们显然更关注非线性幂律关系。
自然界充满这种非线性缩放:树木高度的极限、动物的骨骼强度、代谢率等都表现出不同指数的幂律关系,这也是后来的克莱伯定律等更多规模法则的理论前提。
数量级与对数表示
在规模分析的框架下,数量级和对数刻度是两个极为重要的概念[2]。数量级(order of magnitude)指的是一个数值以 10 为底的幂次表示方式,用于描述跨越巨大尺度的变化。例如,[math]\displaystyle 10^1, 10^2, 10^3, \dots[/math]分别代表十、百、千这样成倍扩展的规模。对数刻度则能将等比数列转换为等差数列,例如对上面的序列取10为底的对数,则得到[math]1,2,3,\dots[/math]。
里氏(局地)震级[math]M_L[/math]本质上与地震记录到的最大振幅的常用对数有关;在相同条件与校正下,震级每增加 1,记录振幅约增大10 倍,因此相差2级时振幅约相差100倍。实际观测振幅还会随距离与场地条件变化,报告中也常用矩震级[math]M_w[/math]。
数量级与对数表示
除此之外,对数表示与规模法则,或更广泛的幂律关系也存在着深刻联系。这是因为,对数表示可以将幂律关系转变为线性关系。
如果对1式两边都取10为底的对数,则可以得到:
-
[math]\displaystyle{ \log Y = \alpha \log X + \log c }[/math]
(linear)
如果将[math]\log X[/math]和[math]\log Y[/math]看作两个新的变量[math]X',Y'[/math],则上式表达了[math]X',Y'[/math]二者之间的一个线性关系,且该线性方程的斜率为[math]\alpha[/math],截距为[math]\log c[/math]。
从数量级的角度来说,linear式表达的含义是:[math]Y[/math]变量的数量级是[math]X[/math]变量的[math]\alpha[/math]倍。
实证数据分析方法
这种线性关系很方便我们用线性回归,例如最小二乘法(Ordinary Least Square,简称OLS)或主轴回归法(Major Axis,简称MA)来根据数据求出方程中的斜率[math]\alpha[/math]和截距[math]\log c[/math]。
在实证数据分析中,例如原始数据为所有国家的人口([math]X[/math])与GDP([math]Y[/math]),则我们可以对这两组数据取对数得到线性化的变量[math]\log X[/math]与[math]\log Y[/math],讲这些对数化后的数据绘制到以[math]\log X[/math]为横坐标,以[math]\log Y[/math]为纵坐标的散点图上,通常能够得到一条近似的直线型的带状区域。进一步,我们可以使用最小二乘法(OLS)方法进行线性回归,就可以估计出这两组数据的规模法则系数[math]c[/math]和幂指数[math]\alpha[/math]了。最后我们还可以利用决定系数[math]R^2[/math]、F统计量等统计量来反映这组数据符合幂律关系的显著性水平。
相对增长关系
如果我们对式linear两边求差分(即考察[math]X,Y[/math]的变动情况,以及二者之间的关系),并注意到对数函数的求导法则([math]\Delta\log X\approx\Delta X/X[/math]),则有:
-
[math]\displaystyle{ \frac{\Delta Y}{Y} \approx \alpha \frac{\Delta X}{X} }[/math]
(growth_rate)
这里,[math]\frac{\Delta Y}{Y}[/math]和[math]\frac{\Delta X}{X}[/math]分别是[math]Y[/math],[math]X[/math]的增长率。
因此,growth_rate式表达的含义是:[math]Y[/math]的增长率是[math]X[/math]的[math]\alpha[/math]倍。
也就是说,规模法则1式实际上隐含了两个变量的相对增长速度关系,当[math]X[/math]增长1倍以后(即[math]\Delta X/X=1[/math]),[math]Y[/math]增长了[math]\alpha[/math]倍。
例如,地震能量释放是与里氏震级幂指数为1.5的规模法则,这意味着:震级每增加1单位,也就是地震波幅度增加一个数量级,地震释放的能量增加约 [math]10^{1.5} \approx 31.6[/math] 倍。
非幂律形式的规模法则
尽管无论在自然界还是经济社会等复杂系统之中,以幂律关系形式呈现的规模法则都普遍存在,但人们也发现了很多非幂律形式的规模法则。这类规模法则可以以非幂律形式的非线性函数为表现形式,常见的有对数关系,如[math]Y\propto \log X[/math],修正的幂律形式:[math]Y\propto (X+C)^{\alpha}[/math],其中[math]C[/math]为一修正参数,等等。
生物的规模法则
生物界中广泛存在着各种规模法则,这些规律揭示了生物体大小与形状、结构、功能、行为等变量之间的幂律关系。在很多文献中,规模法则又被称为异速生长(Allometry),或异速生长律,它表明当生物体规模变化时,不同特征并非按相同比例缩放,而是遵循特定的异速生长规律。例如,招潮蟹的钳子大小随身体大小增长时,其增长速度要快于身体本身的增长速度[10];动物的脑袋大小与身体体重之间也存在类似的异速生长关系。这些规模法则在个体发育(如螃蟹从小到大的生长过程)和种间比较(如不同物种间的特征对比)中都有所体现[11]。
在这些规模法则中,生物体的新陈代谢率与体重的关系尤为重要,也最为著名,被称为克莱伯定律(Kleiber's law),它描述了生物体的新陈代谢率如何与体重按幂律关系缩放,被誉为"生物学的开普勒定律"。围绕克莱伯定律的发现和解释,科学家进行了长期研究。
鲁布纳猜想
19世纪末,德国生理学家马克斯·鲁布纳(Max Rubner)基于热量交换的考量,猜想动物代谢率与其体表面积成正比[12], 这是克莱伯定律研究的起点。根据几何相似原理,体表面积通常与体积的 [math]\frac{2}{3}[/math] 次方成正比,而体积又近似与质量成正比。因此,鲁布纳预言代谢率 [math]F[/math] 和体重 [math]M[/math] 满足如下关系:
- [math]\displaystyle{ F \propto M^{\frac{2}{3}} }[/math]
这意味着如果某动物的体重增加一倍,其代谢总需求将增加约 [math]2^{\frac{2}{3}} \approx 1.59 [/math] 倍,而非成比例翻倍。鲁布纳通过对狗等少数动物的实验测量初步验证了这一关系,并于1902年正式提出,一度成为生理学教条。然而,后来研究指出其样本量小、实验条件不严谨等局限性。
克莱伯定律(Kleiber's Law)
真正的突破来自瑞士科学家马克斯·克莱伯(Max Kleiber)。1932年,克莱伯在分析了大量跨物种的数据后,发表了一篇重要论文。他将各种哺乳动物的体重作为横坐标,并通过它们在单位时间内呼出的二氧化碳,分别测量出它们的新陈代谢率作为纵坐标。结果显示,生物代谢率与体重的幂律关系并非鲁布纳所认为的 [math]\frac{2}{3}[/math],而是接近 [math]\frac{3}{4}[/math]。这一发现标志着克莱伯定律的诞生。
代谢、体重的 3/4 幂律
克莱伯定律的核心是 [math]\frac{3}{4}[/math] 幂律,它实质上是对鲁布纳 [math]\frac{2}{3}[/math] 幂律的修正和拓展。在更广泛的物种范围和更精确的数据支持下,克莱伯确定了生物的基础代谢率 F 与体重 M 之间的关系:
-
[math]\displaystyle{ F \propto M^{\frac{3}{4}} }[/math]
(2)

这一定律表明,生物体规模每扩大一倍,代谢总量仅增加约 [math]2^{\frac{3}{4}} \approx 1.68 [/math] 倍。与之相对应,单位质量的代谢速率随着生物体增大而降低。例如,大象每公斤组织消耗的能量远低于老鼠每公斤组织的能量消耗。这解释了为什么大型动物会比小型动物更“节能”[13]。

West等人在2002年的研究[14]对克莱伯 [math]\frac{3}{4}[/math] 幂律进行了扩展,涵盖的量级范围超过了 27 个数量级,从个体(蓝色圆圈)到未偶联的哺乳动物细胞、线粒体和呼吸复合体中的末端氧化酶分子(细胞色素 c 氧化酶,CcO)(红色圆圈)。图中还显示了单细胞生物的数据(绿色圆圈)。在最小的哺乳动物(鼩鼱)以下的区域,根据预测,新陈代谢率与体重的关系将线性外推至体外的单个细胞,如虚线所示。在细胞和细胞内部的水平上,[math]\frac{3}{4}[/math] 幂律再次出现(如红色直线所示)。
克莱伯定律的发现最初让生物学家们困惑不已,因为它偏离了简单的几何比例。然而,现代的 WBE模型(West-Brown-Enquist 模型)等研究认为,生物体内如血管系统、呼吸道等分形网络结构经过优化,以实现能量传输效率的最大化,从而产生了 [math]\frac{3}{4}[/math] 的幂指数,而非欧氏几何的 [math]\frac{2}{3}[/math]。
城市的规模法则
在城市科学和城市规划中,同样存在着引人注目的规模法则。这些规模法则分为了三大类:与社会互动相关的超线性规模法则(Super-linear scaling law)、与个人需求相关的线性规模法则(Linear scaling law),和与基础设施相关的亚线性规模法则(Sub-linear scaling law)。城市的规模一般用人口数[math]N[/math]来衡量。
与社会互动相关的超线性规模法则
首先,与生物不同的是,城市中的许多社会经济指标随规模呈现"超线性"增长,即幂指数大于 1 。这意味着大城市不仅绝对产出更多财富和创新成果,而且相对而言更高效,即大城市的人均产出更高。除此之外,城市也存在着大量的负面因素,例如犯罪、疾病传播、环境污染等,研究表明,这些负面因素也大多与规模呈现超线性规模法则。无论正向与负向,这类超线性规模法则的起源被认为都可以归结为人与人之间的互动(interaction)的。互动既可以创造财富和科技创新,也同样会带来犯罪和疾病传播[2]。
GDP
城市的GDP与人口规模存在着如下的规模法则:
-
[math]\displaystyle{ Y = Y_0N^\beta \quad (\text{其中 } \beta \gt 1) }[/math]
(3)
其中,[math]Y[/math]代表城市的GDP水平,[math]N[/math]代表城市的人口规模,[math]\beta[/math]为规模法则的幂指数,[math]Y_0[/math]为规模法则的系数,含义为单人城市的产出GDP(即城市只剩下一个人时候的产出水平)。在中国和美国的城市中,GDP 与人口数[math]N[/math]的幂指数 [math]\beta[/math] 约为 1.15。这一关系意味着,当城市人口增加一倍,GDP 增长约 [math]2^{1.15} \approx 2.22[/math] 倍,人均 GDP 也会随之提升。这反映了城市中的网络效应和聚集效应——人口规模增长带来更频繁的人际交互和知识溢出,使得整体产出以超过线性的速度提高。

下表给出了更多国家城市的GDP与人口规模法则的幂指数[16]:
| 指标 | [math]\beta[/math] | 95% CI | Adj-R² | 观察值 | 国家 - 年份 |
|---|---|---|---|---|---|
| GDP | 1.15 | [1.06,1.23] | 0.96 | 295 | 中国 2002 |
| GDP | 1.26 | [1.09,1.46] | 0.64 | 196 | 欧盟 1999-2003 |
| GDP | 1.13 | [1.03,1.23] | 0.94 | 37 | 德国 2003 |
CI,置信区间;Adj-R²,调整R²;GDP,国内生产总值。
Bettencourt等人的研究[15]发现,GDP(国内生产总值)是超线性增长的,其规模指数 β 在 1.06 到 1.26 之间。具体数据显示:
- 中国:2002 年的 GDP 指数 [math]\beta[/math]=1.15。
- 欧盟:1999-2003 年的 GDP 指数 [math]\beta[/math]=1.26。
- 德国:2003 年的 GDP 指数 [math]\beta[/math]=1.13。
科技创新
除了 GDP 之外,城市的创新指标也会呈现超线性规模法则
Bettencourt等人在2007年的研究[17]指出,城市人口规模(N)与发明活动(以专利数量 Y 衡量)之间的关系,发现两者同样遵循超线性幂律关系,幂律指数约为 1.27,同样大于 1。这个超线性关系表明,随着城市人口规模的增加,人均发明产出也随之提高,体现了发明活动的规模报酬递增效应。
- 超线性 ([math]\beta[/math]>1):这类指标反映了城市独特的社会特征,表明知识溢出推动了增长。随着城市规模的扩大,人均产出增加。
- 创新和财富创造:新专利 ([math]\beta[/math]=1.27)、发明家数量 ([math]\beta[/math]=1.25)、私营研发就业 ([math]\beta[/math]=1.34)、“超创意”就业 ([math]\beta[/math]=1.15)、研发机构 ([math]\beta[/math]=1.19) 和研发就业 ([math]\beta[/math]=1.26) 等指标均呈超线性增长。
- 社会财富:总工资 ([math]\beta[/math]=1.12) 和银行总存款 ([math]\beta[/math]=1.08) 也呈超线性增长。
- 负面社会影响:新增艾滋病病例 ([math]\beta[/math]=1.23) 和严重犯罪 ([math]\beta[/math]=1.16) 等指标同样呈超线性增长,表明这些负面影响随着城市规模的扩大而加剧。
与科技创新、财富创造有关的正向超线性规模法则幂指数列表:
| 指标 | [math]\beta[/math] | 95% CI | Adj-R² | 观察值 | 国家 - 年份 |
|---|---|---|---|---|---|
| 新专利 | 1.27 | [1.25,1.29] | 0.72 | 331 | 美国 2001 |
| 发明家 | 1.25 | [1.22,1.27] | 0.76 | 331 | 美国 2001 |
| 私营研发就业 | 1.34 | [1.29,1.39] | 0.92 | 266 | 美国 2002 |
| "超创意"就业 | 1.15 | [1.11,1.18] | 0.89 | 287 | 美国 2003 |
| 研发机构 | 1.19 | [1.14,1.22] | 0.77 | 287 | 美国 1997 |
| 研发就业 | 1.26 | [1.18,1.43] | 0.93 | 295 | 中国 2002 |
| 总工资 | 1.12 | [1.09,1.13] | 0.96 | 361 | 美国 2002 |
| 银行总存款 | 1.08 | [1.03,1.11] | 0.91 | 267 | 美国 1996 |
负面指标:社会熵
另外,城市就是一个大熔炉,人与人之间的互动除了产生财富和科技创新之外,也会带来负面影响,在《规模》一书中,作者将其所有这些指标统称为社会熵[2]。
城市规模扩大的另一面是负面效应也在放大:
-
[math]\displaystyle{ S = S_0 N^\beta \quad (\text{其中 } \beta \gt 1) }[/math]
(6)
这里的[math]S[/math]即代表社会熵,它可以是犯罪率、传染病新增病例、污染等,它们同样与城市人口之间存在超线性关系[18]。
| 指标 | β | 95% CI | Adj-R² | 观察值 | 国家 - 年份 |
|---|---|---|---|---|---|
| 新增艾滋病病例 | 1.23 | [1.18,1.29] | 0.76 | 93 | 美国 2002-2003 |
| 严重犯罪 | 1.16 | [1.11,1.18] | 0.89 | 287 | 美国 2003 |
| 暴力犯罪 | 1.2 | [1.15,1.25] | 27; 5570 | 巴西 2003-2007 | |
| 暴力犯罪 | 1.2 | [1.07,1.33] | 12 | 日本 2008 |
这揭示了城市作为复杂巨系统的内在矛盾:一方面,人口集聚带来超线性的繁荣;另一方面,也滋生了超线性的混乱。
社会连接度
Bettencourt等人认为,之所以城市会存在上述超线性规模法则,包括正面和负面,本质原因是源于人与人之间的互动。为了佐证这一观点,他们专门对社会连接作为社会互动的代理量,进行了实证性的验证。
Andris和Bettencourt于2014年采用了规模法则来描述城市连接度与其人口规模之间的关系[19]。这个关系可以用一个幂律函数来表示:
-
[math]\displaystyle{ C=C_0N^b }[/math]
(5)
其中:
- [math]C[/math] 代表城市的连接度(connectivity),在这项研究中具体指一个地区的总电话呼叫量(包括呼出和呼入)。
- [math]N[/math] 代表该地区的人口规模(population size)。
- [math]C_0[/math] 是一个归一化常数。
- [math]b[/math] 是规模指数或幂指数(scaling exponent),它衡量了人均社会连接度随城市人口规模变化的程度。

图中的每一个蓝点代表科特迪瓦的一个行政区。这些数据点在人口的对数-呼出/呼入电话总量的对数坐标系下呈现出明显的线性上升趋势,证明了呼出/呼入电话量与人口规模之间存在幂律关系。
幂指数b的具体数值:
- 总体连接度指数:研究发现,b=1.26(95%置信区间为 [1.19, 1.34]),属于“超线性”(super-linear)增长。换言之,大城市里的居民平均比小城镇的居民拥有更多的社会互动(以电话通信衡量),城市的社会经济过程会随着城市规模的扩大而加速。
- 内部通话连接度指数:只分析城市内部的通话时,这个指数变得更高,b=1.49(95%置信区间为 [1.39, 1.58])。这表明,随着科特迪瓦的城市不断发展壮大,其内部通话在总通话量中所占的比例会越来越高。
与个人需求相关的线性规模法则
- 线性 ([math]\beta[/math]≈1):这类指标通常与满足个人需求相关,其增长率与人口增长率成正比,即人均指标保持不变。相应的规模法则包括:
- 个人需求:例如住房总量 ([math]\beta[/math]=1.00) 和总就业量 ([math]\beta[/math]=1.01)。
- 家庭消费:德国家庭用电量 ([math]\beta[/math]=1.00)、中国家庭用电量 ([math]\beta[/math]=1.05) 和中国家庭用水量 ([math]\beta[/math]=1.01) 也大致呈线性增长。
| 指标 | [math]\beta[/math] | 95% CI | Adj-R² | 观察值 | 国家 - 年份 |
|---|---|---|---|---|---|
| 总住房 | 1 | [0.99,1.01] | 0.99 | 316 | 美国 1990 |
| 总就业 | 1.01 | [0.99,1.02] | 0.98 | 331 | 美国 2001 |
| 家庭电力消耗 | 1 | [0.94,1.06] | 0.88 | 377 | 德国 2002 |
| 家庭电力消耗 | 1.05 | [0.89,1.22] | 0.91 | 295 | 中国 2002 |
| 家庭用水消耗 | 1.01 | [0.89,1.11] | 0.96 | 295 | 中国 2002 |
与基础设施相关的亚线性规模法则
- 亚线性 ([math]\beta[/math]<1):这类指标代表基础设施,其特点是随着城市规模的扩大,效率会提高,即人均需求会减少。相应的规模法则包括:
- 基础设施:加油站 ([math]\beta[/math]=0.77)、汽油销量 ([math]\beta[/math]=0.79)、电缆长度 ([math]\beta[/math]=0.87) 和道路面积 ([math]\beta[/math]=0.83) 等指标均呈亚线性增长。这表明,较大的城市在基础设施方面实现了规模经济。
| 指标 | [math]\beta[/math] | 95% CI | Adj-R² | 观察值 | 国家 - 年份 |
|---|---|---|---|---|---|
| 加油站 | 0.77 | [0.74,0.81] | 0.93 | 318 | 美国 2001 |
| 汽油销售 | 0.79 | [0.73,0.80] | 0.94 | 318 | 美国 2001 |
| 电缆长度 | 0.87 | [0.82,0.92] | 0.75 | 380 | 美国 2001 |
| 道路面积 | 0.83 | [0.74,0.92] | 0.87 | 29 | 德国 2002 |
城市规模法则总体概括
总结概括上述发现,可以概括出下表:
| 变量名 (Y) | 变量描述 | 幂指数 [math]\beta[/math] | 95% CI | Adj-[math]R^2[/math] | 观测数 | 国家-年份 |
|---|---|---|---|---|---|---|
| New patents | 新专利 | 1.27 | [1.25,1.29] | 0.72 | 331 | 美国 2001 |
| Inventors | 发明家 | 1.25 | [1.22,1.27] | 0.76 | 331 | 美国 2001 |
| Private R&D employment | 私营研发就业人数 | 1.34 | [1.29,1.39] | 0.92 | 266 | 美国 2002 |
| "Supercreative" employment | "超创意"就业人数 | 1.15 | [1.11,1.18] | 0.89 | 287 | 美国 2003 |
| R&D establishments | 研发机构 | 1.19 | [1.14,1.22] | 0.77 | 287 | 美国 1997 |
| R&D employment | 研发就业人数 | 1.26 | [1.18,1.43] | 0.93 | 295 | 中国 2002 |
| Total wages | 总工资 | 1.12 | [1.09,1.13] | 0.96 | 361 | 美国 2002 |
| Total bank deposits | 银行总存款 | 1.08 | [1.03,1.11] | 0.91 | 267 | 美国 1996 |
| GDP | 国内生产总值 | 1.15 | [1.06,1.23] | 0.96 | 295 | 中国 2002 |
| GDP | 国内生产总值 | 1.26 | [1.09,1.46] | 0.64 | 196 | 欧盟 1999-2003 |
| GDP | 国内生产总值 | 1.13 | [1.03,1.23] | 0.94 | 37 | 德国 2003 |
| Total electrical consumption | 总用电量 | 1.07 | [1.03,1.11] | 0.88 | 392 | 德国 2002 |
| New AIDS cases | 新增艾滋病病例 | 1.23 | [1.18,1.29] | 0.76 | 93 | 美国 2002-2003 |
| Serious crimes | 严重犯罪 | 1.16 | [1.11,1.18] | 0.89 | 287 | 美国 2003 |
| - | - | - | - | - | - | - |
| Total housing | 住房总量 | 1.00 | [0.99,1.01] | 0.99 | 316 | 美国 1990 |
| Total employment | 总就业人数 | 1.01 | [0.99,1.02] | 0.98 | 331 | 美国 2001 |
| Household electrical consumption | 家庭用电量 | 1.00 | [0.94,1.06] | 0.88 | 377 | 德国 2002 |
| Household electrical consumption | 家庭用电量 | 1.05 | [0.89,1.22] | 0.91 | 295 | 中国 2002 |
| Household water consumption | 家庭用水量 | 1.01 | [0.89,1.11] | 0.96 | 295 | 中国 2002 |
| - | - | - | - | - | - | - |
| Gasoline stations | 加油站数量 | 0.77 | [0.74,0.81] | 0.93 | 318 | 美国 2001 |
| Gasoline sales | 汽油销量 | 0.79 | [0.73,0.80] | 0.94 | 318 | 美国 2001 |
| Length of electrical cables | 电缆长度 | 0.87 | [0.82,0.92] | 0.75 | 380 | 德国 2002 |
| Road surface | 道路表面积 | 0.83 | [0.74,0.92] | 0.87 | 29 | 德国 2002 |
用离差评估城市
城市规模法则不仅揭示了城市普适的缩放生长规律,而且还能够用于评估个体城市的发展水平。Bettencourt等人发表于2010年的研究[20]通过分析城市规模与各项指标(如经济、创新、犯罪等)之间的非线性关系,提出了“离差指标”的方法。该方法的核心在于区分因城市规模而产生的普遍性效应与特定城市独有的局部动态。传统的人均指标往往将这两者混为一谈,而“离差评估”则通过一套城市指标(SAMIs)来衡量一个城市与其规模所预期的平均水平之间的偏差。该方法基于以下两个主要公式:
城市指标的幂律定标法则(Scaling Law)
这是描述城市指标(Y)与人口规模(N)之间平均关系的基础公式:
-
[math]\displaystyle{ Y(t)=Y_0N(t)^{\beta} }[/math]
(7)
其中:
- [math]Y(t)[/math] 是城市指标在时间 t 的值。
- [math]N(t)[/math] 是时间 t 的人口规模。
- [math]Y_0[/math] 是一个归一化常数。
- [math]\beta[/math] 是定标指数。当 [math]\beta \approx 1.15[/math] 时,表示该指标具有超线性增长效应,即人口每增加一倍,该指标的人均值将系统性地增加约15%。
尺度调整后的大都市区指标(SAMIs)
该指标用于量化每个特定城市相对于其规模所预期的平均水平的偏差(离差)。
-
[math]\displaystyle{ \log\left[\frac{Y_i}{Y(N_i)}\right] = \zeta_i }[/math]
(8)
其中:
- [math]Y_i[/math] 是某个特定城市的指标观察值。
- [math]Y(N_i)[/math] 是根据公式7预测的该城市规模下的平均值。
- [math]\zeta_i[/math] 是 SAMI 值,它是一个无量纲的指标,与城市规模无关,反映了该城市独有的成功或失败。
企业的规模法则
企业作为经济系统的基本单元,同样展现出多种规模法则。为了理解这些规律,我们可以从不同的角度来衡量和分析公司的规模,其中最常见的两种视角分别是将其视为现金流系统和人员组织系统,前者以总资产为企业规模的衡量标准,后者则以员工数为企业规模的衡量标准。
作为现金流系统:基于总资产的规模法则
将一家公司的总资产(Total Assets)视为其“体重”,各类财务流(如收入、成本、利润、债务等)视为“类新陈代谢”指标,则可以发现它们之间普遍存在显著的幂律关系。基于这一类比,张江等学者的研究[21]分析了全球数万家上市公司的财务数据,考察各主要财务变量相对于总资产的标度行为,发现所有考察的财务指标与总资产之间均存在显著的幂律关系:
- [math]\displaystyle{ X\propto A^{\beta} }[/math]

这里,[math]X[/math]是某种财务指标,例如收入、成本、利润等,[math]A[/math]为企业的总资产规模,这些变量都可以用美元或人民币来衡量。
下面,重点看几种规模法则:
收入与成本
美中欧公司的总收入(Revenue, R)和总成本(Cost of Operator, C)都与总资产(Total Assets, A)普遍呈现亚线性关系,即幂指数 [math]\beta [/math] 略小于 1(中国的 Cost of Operator除外)。
- [math]R \propto A^{\beta} [/math]
- 美国:[math]\beta = 0.91[/math]
- 中国:[math]\beta = 0.92[/math]
- 欧洲:[math]\beta = 0.93[/math]
- [math]C \propto A^{\beta} [/math]
- 美国:[math]\beta = 0.81[/math]
- 中国:[math]\beta = 1.02[/math]
- 欧洲:[math]\beta = 0.96[/math]
收入和成本的亚线性关系意味着,企业规模越大,平均每单位资产产生的收入或成本就越低。这体现了企业经营中的规模报酬递减现象。随着资产规模的扩大,企业可能面临市场饱和、管理效率下降等问题,导致新增资产带来的边际收益减少。
利润
净利润(Net Income, I)作为收入扣除成本后的剩余(只保留正数的部分),与企业规模之间也遵循亚线性规模定律,而且其幂指数往往比收入更低。而且不同市场的利润幂指数相近,在0.85左右。
- [math]I \propto A^{\beta}[/math]
- 美国:[math]\beta = 0.85[/math]
- 中国:[math]\beta = 0.83[/math]
- 欧洲:[math]\beta = 0.87[/math]
该幂律关系表明,大公司的利润增长速度慢于资产的增长。也就是说,企业规模越大,在保持利润率方面反而越困难,这与生物体越庞大单位质量所消耗的能量越少类似,因此张江等人将这一发现称为企业中的广义克莱伯定律。
债务
公司的总债务(Liability, L)与总资产之间的幂律关系,则反映了不同市场环境下资本分配的差异。
- [math]L \propto A^{\beta} [/math]
- 美国:[math]\beta = 1.00[/math]
- 中国:[math]\beta = 1.09[/math]
- 欧洲:[math]\beta = 1.08[/math]
在美国市场中,总债务随总资产近似线性增长,表明大、小企业平均负债率相差不大。中国、欧洲企业的债务规模法则呈现超线性特征,这说明公司在变大时,其负债增长速度快于资产本身的增长。这体现了“强者愈强”的资本倾斜现象,大型企业更容易获得贷款,但同时也潜藏着更高的财务风险。
作为人员的组织系统:基于员工数的规模法则
如果将企业看作是一个由人员构成的系统,则我们也可以用企业的雇员总数作为企业规模的衡量。因此,此时的规模法则表现为各项变量与员工数(E)与总雇员数规模之间的关系可以用这个公式来描述[18]:
[math]Y = cE^{\gamma}[/math]
其中:
- [math]Y[/math] 代表了各个财务指标变量,如总销售额、总资产、研发支出等。
- [math]E[/math] 代表雇员数,是衡量企业规模的基底。
- [math]\gamma[/math] (伽马) 是幂指数,是衡量变量随企业规模(员工数)增长的速度。
- [math]c[/math] 是一个比例系数,命名为:单人产出/销售/成本,代表的是当企业只有一个人的时候,它的产出/销售/成本等。
其中,以上市的3万多家北美企业数据拟合出的各个不同财务指标的规模法则系数与幂指数列表如下:
| 变量名 | 变量描述 | 幂指数 [math]\gamma[/math] | 标准差 | 系数 c(S) | R² |
|---|---|---|---|---|---|
| 总销售额 | 总的销售额 | 0.99 | 0.03 | 293 978 | 0.80 |
| 总税收 | 总收入税收 | 0.96 | 0.06 | 731 | 90.56 |
| 销售成本 | 由销售引发的成本 | 0.96 | 0.03 | 229 609 | 0.78 |
| 总利润 | 总销售额-销售成本 | 0.89 | 0.03 | 213 788 | 0.75 |
| 长期债务 | 超过1年的债务 | 0.88 | 0.06 | 187 753 | 0.40 |
| 总资产 | 公司拥有的价值 | 0.87 | 0.03 | 1 354 206 | 0.64 |
| EBITDA | 总利润-成本,即折旧之前的 | 0.87 | 0.04 | 114 494 | 0.62 |
| 净利润 | 总利润-分红 | 0.82 | 0.05 | 422 523 | 0.57 |
| 利息成本 | 利息支出 | 0.79 | 0.05 | 25 069 | 0.43 |
| 现金量 | 手头上的现金 | 0.78 | 0.04 | 230 302 | 0.49 |
| 优先股金 | 同时具备股权和债权的股票 | 0.76 | 0.18 | 54 712 | 0.23 |
| 净收入 | 总销售额-总支出 | 0.76 | 0.05 | 133 413 | 0.54 |
| 管理成本 | 管理成本 | 0.75 | 0.02 | 386 778 | 0.77 |
| 普通股分红 | 给普通股持有者派发的现金 | 0.69 | 0.07 | 122 400 | 0.45 |
| 1年期债务 | 1年到期的债务 | 0.69 | 0.07 | 46 936 | 0.31 |
| 研发支出 | 研究与开发支出 | 0.65 | 0.06 | 170 183 | 0.48 |
| 店面数量 | 公司旗下经营的店铺数量 | 0.61 | 0.17 | 1677 | 0.46 |
| 收购企业对销售的贡献 | 收购企业对销售的贡献 | 0.61 | 0.25 | 496 | 0.27 |
| 不被母公司拥有的子公司股份比例 | 不被母公司拥有的子公司股份比例 | 0.60 | 0.10 | 126 543 | 0.26 |
| 优先股分红 | 优先股分红 | 0.54 | 0.11 | 78 947 | 0.30 |
| 开店数量 | 当年公司新开店铺数量 | 0.41 | 0.27 | 364 | 0.16 |
| 股东数量 | 拥有公司股票的个体的数量 | 0.27 | 0.05 | 128 | 0.07 |
| 关店数量 | 当年公司关店的数量 | 0.25 | 0.28 | 1079 | 0.07 |
| 收购企业对收入的贡献 | 收购企业对收入的贡献 | 0.17 | 0.39 | 1128 | 0.03 |
| 部门数量 | 独立的部门数量 | 0.12 | 0.01 | 813 541 | 0.21 |
表格中的数据揭示了几个重要的发现:
- 亚线性规模法则:表格中所有的幂指数 [math]\gamma[/math] 都小于1,这表明当企业规模(员工数)扩大时,所有的变量都以比员工数增长更慢的速度增长。这与城市和互联网社区的超线性增长([math]\gamma > 1[/math])形成鲜明对比,也表明企业并非是一种高效的人类组织。
- 人均产出的下降:由于所有变量的增长速度都比员工数慢,这意味着人均值(如人均销售额、人均资产、人均研发支出)都会随着企业规模的扩大而减小。这表明“大企业病”的存在,即公司规模越大,效率反而可能越低。
- 不同变量的增长速度不同:尽管所有变量的幂指数都小于1,但它们的值各不相同,这表明不同变量随企业规模增长的速度是不同的。
- 增长最快:总销售额([math]\gamma = 0.99[/math])和总税收、销售成本([math]\gamma = 0.96[/math])等财务收入和成本的增长速度最接近员工数。
- 增长较慢:开店数量([math]\gamma = 0.41[/math])、股东数量([math]\gamma = 0.27[/math])、关店数量([math]\gamma = 0.25[/math])和部门数量([math]\gamma = 0.12[/math])等变量的幂指数非常低。
尽管企业规模在扩大,但其产出和各项指标的增长并未跟上员工数量的增长,这体现了企业在效率方面的局限性。
虽然上述表格展示了规模法则的一般规律,但对比中美两国企业的数据可以发现,它们在基于员工数的规模法则上存在显著差异[18]。这种差异不仅体现在幂指数 [math]\gamma[/math] 的数值上,更重要的是体现在比例系数[math]c[/math]的系统性差异上。对于相同的变量(如总销售额、净利润等),两国企业的 [math]c[/math] 值往往不同,这反映了不同的发展阶段和效率模式。具体而言,中国企业由于处于更快速的发展阶段,其 [math]c[/math] 值在某些产出指标上可能更高,体现了快速增长阶段的市场活力和单位员工的产出潜力;但在管理成本、组织复杂度相关指标上,可能存在不同的结构特征。这种系统性差异反映了多个层面的因素:一是市场发展阶段的不同,中国企业整体处于更快速的发展轨道;二是企业管理模式和资源配置效率的差异;三是宏观经济环境的差异,中国的经济增长速度长期以来快于美国。从预测误差分布的角度看,中美两国企业的生长率分布都呈现右偏特征,表明两国企业都遵循相似的规模法则规律,但在具体的效率参数(尤其是 [math]c[/math] 值)上存在系统性差异。这进一步说明,虽然规模法则是普适的,但不同发展阶段和市场环境会塑造出不同的效率基础[18]。
用离差评估企业
与城市的规模法则研究类似,企业的规模法则不仅揭示了市场中所有企业的普遍规律,也可以用个体企业偏离规模法则的程度,评估每个个体企业在各个财务指标上的健康状况。
首先,我们可以通过绘制双对数坐标图来研究某个变量(如总利润)与企业规模(如总销售额)之间的关系。在理想状态下,这些数据点会落在一条直线上,这条直线代表了该市场中所有企业在该指标上的平均水平。
其次,对于双对数坐标下的每一个点(代表一家企业),我们可以计算规模法则的离差(或称离差),即该企业的数据点偏离这条平均直线的垂直距离,这个偏离距离就用于评估企业的表现。
- 离差 > 0:如果企业的点位于平均直线的上方,表明该企业在该指标上的表现高于市场平均水平。
- 离差 = 0:如果企业的点正好位于平均直线上,表明该企业的表现恰好等于市场平均水平。
- 离差 < 0:如果企业的点位于平均直线的下方,表明该企业的表现低于市场平均水平。
作为企业的评估指标,企业的离差相比较传统的比例指标(例如,总利润/总销售额)存在着显著优势。这是因为,传统的比例指标没有考虑企业非线性的规模效应,因此存在着局限性。而规模标度律的离差则更具优势,这体现为[22]:
- 考虑了规模效应:规模法则本身已经考虑了规模效应,因此这条直线代表了行业整体的平均水平。通过计算离差,我们可以将一个企业的表现与该行业的平均水平进行公正的比较。
- 更准确的评估:离差能够更准确地反映企业在该指标上的相对表现。当两个不同规模的企业进行比较时,仅使用比例指标是不够的,因为规模效应可能导致不同规模的企业有不同的比例值。离差则将规模效应纳入了考虑,提供了更合理的比较基础。
- 反映市场动态:对于正向指标(例如利润、销售额等),则离差越大,表明企业在该指标上的表现越突出(高于)市场平均水平。在同类企业中,离差越大,说明该企业越成功地获取了更多利润或收入。反之,对于负向指标(如成本),则离差越负(即成本低于行业平均水平),企业表现越好。
例如,下图的雷达图展示了微软和苹果公司在多个财务指标上的离差[18]。通过比较这两个公司各指标的离差值,我们可以看到,它们的离差在所有指标上都大于0,说明两家公司的正向指标表现都高于市场平均水平,但同时也说明成本等负向指标也显著高于行业平均。同时,离差值越大,对于正向指标,排名越靠前,显示了该企业在市场中的领先地位。

规模法则导出的生长方程
之所以人们通过规模法则能够构建统一的理论,是因为在诸多规模法则中,有一类特殊的变量的存在,即“广义的新陈代谢”,这就包括生物体的“新陈代谢率”,城市的“GDP”或更广义的“社会交互”,以及企业中的“净利润”。这类可以代表广义新陈代谢的变量与规模之间的规模法则可以直接推导出复杂系统的一种广义的生长方程。例如,生物体中的“韦斯特方程”。
生物体的生长方程——韦斯特方程
韦斯特(Geoffrey West)等人在2001年的研究[23]中总结了生物体个体发育的生长轨迹,基于代谢能量在维持现有组织生存和⽣产新⽣物量之间分配的基本原理,推导出⼀个通⽤的描述生物体个体发育生长(ontegenetic growth)的方程,即韦斯特方程。
核心方程
首先,我们可以根据能量守恒原理,推出一个方程用来描述代谢能量在生物体内的分配:
-
[math]\displaystyle{ B = \sum_{c}\left[N_c B_c + E_c \frac{dN_c}{dt}\right] }[/math]
(9)
- [math]B[/math] 是生物体在t时刻的平均基础代谢率,即生物体在单位时间内总的摄入能量。
- [math]N_c[/math] 是生物体内的细胞总数。
- [math]B_c[/math] 是单个细胞的代谢率。
- [math]E_c[/math] 是创造一个新细胞所需的代谢能量。
- [math]N_c B_c[/math] 代表维持一个现有细胞所需的能量。
- [math]E_c \frac{dN_c}{dt} [/math] 代表用于产生一个新细胞的能量,即用于生长的能量。
- [math]\sum_c[/math] 对所有细胞求和。
这个方程的推导基于一个前提:生物体的代谢能量被分配用于维持现有生物体系统的能量(即方程右侧的第一项)和产生新组织,即生长所耗费的能量(方程右侧的第二项)。
结合规模法则的生长方程
上述能量平衡方程可以转化为质量增长的微分方程。因为总质量[math]m[/math]等于细胞总数[math]N_c[/math]乘以单个细胞的质量[math]m_c[/math](即[math]m = m_c N_c[/math]),所以方程(9)可以重写为:[math]\frac{dm}{dt} = (\frac{m_c}{E_c})B - (\frac{B_c}{E_c})m [/math],这是描述整个生物体质量增长的方程。
进一步,将这个方程与规模法则联系起来,引入克莱伯定律(Kleiber's Law)的 [math]\frac{3}{4} [/math] 幂律关系,即生物体的静息代谢率[math]B[/math]与其总质量[math]m[/math]遵循以下关系:[math]B = B_0 m^{\frac{3}{4}} [/math],其中[math]B_0[/math]是克莱伯法则的系数。将[math]B = B_0 m^{\frac{3}{4}}[/math]代入上述质量增长方程,便得到了关键的韦斯特生长方程:
-
[math]\displaystyle{ \frac{dm}{dt} = am^{\frac{3}{4}} - bm }[/math]
(10)
这里[math]m[/math]为生物体的总质量,[math]a[/math]和[math]b[/math] 是常数,其中[math]a \equiv \frac{B_0 m_c}{E_c}[/math],[math]B_0[/math]为克莱伯定律的系数,[math]m_c,E_c[/math]分别为单个细胞的平均质量和平均代谢能量,且[math]b \equiv \frac{B_c}{E_c}[/math],其中[math]B_c[/math] 是单个细胞的代谢率,[math]E_c[/math] 是创造一个新细胞所需的代谢能量。
针对不同物种,代入(9)式中的参数具体数值,就可以对方程(10)式进行求解,即得到该物种的个体发育生长曲线。下图展示了四个不同物种的求解结果,并与实际的生长数据进行了比对。可以看出,理论预测与实际曲线吻合得非常好。

解释渐近最大体型 (Determinate Growth)
这个方程解释了为什么生物体具有确定的最大体型(determinate growth),即为什么生物体大多长到一定规模后就停止生长了。
当生物体停止生长时,也就意味着生长率[math]\frac{dm}{dt}=0[/math],此时对应的[math]m[/math]的解即生物体达到的渐近最大体型[math]M[/math]。也就是说,最大体型实际上是韦斯特生长方程(10)式的不动点。从方程中可以看出:[math]0 = aM^{\frac{3}{4}} - bM [/math],从而得到最大体型[math]M[/math]的表达式:[math]M = (\frac{a}{b})^4 = (\frac{B_0 m_c}{B_c})^4 [/math]。这个结果表明,物种之间的最大体型差异主要由其细胞代谢率 [math]B_c [/math] 的系统性变化决定。
统一的、无参数的生长曲线
由于不同物种对应的方程(10)中的参数会不同,因此导致它们具有不同形状的生长曲线。为了消除这些差异,我们可以通过重新定义变量,从而将生长曲线归一化,以得到一条统一的、无参数的生长曲线。
通过将[math]b=a/M^{\frac{1}{4}}[/math]代回生长方程(10),可以得到一个更具普遍性的方程形式:[math]\frac{dm}{dt} = am^{\frac{3}{4}}\left[1 - (\frac{m}{M})^{\frac{1}{4}}\right] [/math]。通过对这个微分方程进行积分,可以得到描述质量[math]m[/math]随时间[math]t[/math]变化的经典S形曲线方程:
-
[math]\displaystyle{ (\frac{m}{M})^{\frac{1}{4}} = 1 - \left[1 - (\frac{m_0}{M})^{\frac{1}{4}}\right]e^{-\frac{at}{4M^{\frac{1}{4}}}} }[/math]
(11)
其中,[math]m_0[/math]是出生时的质量。
这个方程可以被重新整理为一个无参数的普适曲线,首先,我们需要定义两个无量纲量
- 无量纲质量比:[math]\displaystyle{ r \equiv (\frac{m}{M})^{\frac{1}{4}} }[/math]
- 无量纲时间:[math]\displaystyle{ \tau \equiv \frac{at}{4M^{\frac{1}{4}}} - \ln\left[1 - (\frac{m_0}{M})^{\frac{1}{4}}\right] }[/math]
将这两个无量纲量带入韦斯特生长方程(10),可以得到所有物种统一的生长方程(Universal Growth Equation):
- [math]\displaystyle{ r=1-e^{-\tau} }[/math]
这表明,尽管物种大小差异巨大,它们的生长过程在能量分配和时间尺度上具有普适的内在规律。通过以无量纲质量比[math]r[/math]为纵坐标,无量纲时间[math]\tau[/math]为横坐标,重新将不同物种的生长曲线绘制在一起,可以得到一条普适的生长曲线(Universal Growth Curve):

城市生长方程
与生物体的统一生长方程和生长曲线的推导类似,我们也可以从城市的基本规模法则,即(3)式和城市的投入产出预算平衡推导出城市的生长方程。
2007年,Bettencourt等人在[16]一文中得出该生长方程。城市的GDP类比于生物的新陈代谢,为城市创造的总价值。这表明规模法则在城市中同样适用,只是生物体随着体重增大会导致新陈代谢以较慢的速度生长,而城市GDP的超线性规模法则会使城市的新陈代谢率随其规模增大而以更快的速度生长。
核心方程
从规模法则推导出的城市生长方程是:
-
[math]\displaystyle{ \frac{dN(t)}{dt} = (\frac{Y_{0}}{E})N(t)^{\beta} - (\frac{R}{E})N(t) }[/math]
(12)
- [math]N(t)[/math]:城市在时间[math]t[/math]的人口规模;
- [math]Y(t)[/math]:城市在时间[math]t[/math]的资源产出(GDP);
- [math]\frac{dN(t)}{dt}[/math]:人口随时间的变化率,即城市增长率;
- [math]Y_{0}[/math]:规模法则(3)式的系数,代表城市的单人产出,即城市只有一个人的时候,资源产出是多少;
- [math]\beta[/math]:规模法则(3)式的幂律指数(scaling exponent),反映了系统在规模([math]N[/math])缩放的时候,资源产出[math]Y[/math]的相对缩放速度;
- [math]R[/math]:维持每个个体平均所需的资源量;
- [math]E[/math]:增加一个新个体所需的平均资源量。
这个方程是如何得到的呢?
Bettencourt等人首先从一个基本的假设开始:城市的增长受到可用资源及其消耗速度的制约,其中资源 [math]Y[/math] 被用于两个主要方面:一是维持现有的人口生存,二是促使新的人口增长。
1. 资源被分配来维持人口生存和增加新人口。这个关系被表达为:[math]Y = RN + E(\frac{dN}{dt})[/math]
- [math]RN[/math] 代表维持现有 [math]N[/math] 个个体生存所需的资源总量,其中 [math]R[/math] 是维持每个个体所需的资源量。
- [math]E(\frac{dN}{dt})[/math] 代表增加新人口所需的资源总量,其中 [math]E[/math] 是增加一个新个体所需的资源量,[math]\frac{dN}{dt}[/math] 是人口增长率。
2. 接下来,作者将规模法则(Scaling Law)引入这个方程。规模法则描述了城市的资源产出 [math]Y[/math] 与其人口规模 [math]N(t)[/math] 之间的幂律关系:[math]Y(t) = Y_{0}N(t)^{\beta}[/math]
3. 将规模法则的表达式代入资源分配方程中,得到:[math]Y_{0}N(t)^{\beta} = RN(t) + E(\frac{dN}{dt})[/math]
4. 最后,对这个方程进行重新整理,解出人口增长率 [math]\frac{dN}{dt}[/math],从而得到最终的城市生长方程:[math]\frac{dN(t)}{dt} = \frac{Y_{0}N(t)^{\beta} - RN(t)}{E} = (\frac{Y_{0}}{E})N(t)^{\beta} - (\frac{R}{E})N(t)[/math],即(12)式
该生长方程的解析解为:
- [math]\displaystyle{ N(t) = \left\{\frac{Y_{0}}{R} + \left[N^{1-\beta}(0) - \frac{Y_{0}}{R}\right]\cdot\exp\left[-\frac{R}{E}(1-\beta)t\right]\right\}^{\frac{1}{1-\beta}} }[/math]
- [math]N(0)[/math]:为第0期的人口规模,即初始人口规模。
这个生长方程的解的缩放指数 [math]\beta > 1[/math],因此会导致城市人口的增长是无限制的,并将在一个有限的时间内达到“奇点”(Singularity),即城市规模的增长速度比指数增长还要快。这反映了城市独特的自催化(autocatalytic)性质,即城市规模的扩大能通过创新和社交互动等过程进一步加速自身的增长。
城市与生物的区别
城市生长方程与生物的核心区别在于其内在机制和增长模式:
- 增长极限:生物的生长方程(如West方程)解释了为什么生物体最终会达到一个确定的最大体型(determinate growth)。这是因为生物体的生长方程(10)的右侧的两项分别代表代谢摄入的能量与维持成本。由于代谢能量随体重增加(亚线性)比维持成本(线性)随体重增加得更慢,所以这就会存在着一个平衡点,达到平衡时,增长便会停止。相比之下,城市的超线性规模法则([math]\beta > 1[/math])意味着其在理论上没有增长上限,除非面临外部资源约束,否则将持续加速。
- 内在机制:生物的生长由能量在维持现有组织和创造新组织之间的分配决定,其代谢效率随规模增大而降低。城市的增长是社会经济活动的结果,其超线性本质源于人口密度增加所带来的创新、财富创造和信息流动效率的提升。
- 规模法则差异:生物体的关键属性(如代谢率)随体型呈亚线性规模法则,即 [math]\beta = \frac{3}{4}[/math]。而城市的创新率、收入和专利数量等关键社会经济指标则随人口呈超线性规模法则,即 [math]\beta > 1[/math],这正是城市区别于前两者的根本特征。
超指数增长:繁荣与崩溃
Bettencourt等[16]提出,由超线性规模法则([math]\beta > 1[/math])驱动的城市增长,这种增长模式被称“繁荣-崩溃”(boom/collapse)模式。方程(12)的解分为两种情况:
1. 当[math]N(0)<N^*= {(\frac{R}{Y_{0}})^{\frac{1}{\beta-1}}}[/math]时:
该公式表明,城市的生长存在着一个临界人口规模阈值,即[math]N^*= {(\frac{R}{Y_{0}})^{\frac{1}{\beta-1}}}[/math]。这个阈值正比于维持每个个体平均所需的资源量[math]R[/math],反比于单人城市产出规模。当初始的人口规模(即[math]N(0)[/math])小于这个阈值时,则系统走向崩溃(collapse),此时的生长曲线呈现如下图所示。这反映了城市人口规模达不到临界要求,而导致的不稳定性和脆弱性[16]。

2. 当[math]N(0)>N^*= {(\frac{R}{Y_{0}})^{\frac{1}{\beta-1}}}[/math]时
即当初始人口规模超越阈值时,城市呈现超指数增长,即在有限时间内,人口规模[math]N(t)[/math]达到无穷大,其生长曲线表现为如下图所示。

其中[math]t_c[/math]为人口规模达到无穷的时间点,该点也被称为有限时间奇点。
奇点
根据城市生长方程(12),城市的增长过程会在繁荣与崩溃之间循环。在这个动态过程中,存在两种性质不同的奇点:有限时间奇点(finite time singularity)和不可回避的奇点(unavoidable singularity)。
有限时间奇点
真实的城市增长,会在繁荣与崩溃二者之间切换。即当初期,满足条件[math]N >{(\frac{R}{Y_{0}})^{\frac{1}{\beta-1}}}[/math]的时候,城市进入超指数(super-exponential)增长曲线,并在一个有限时间 [math]t_c[/math] 处发散(即有限时间奇点(finite time singularity))。这个 [math]t_c[/math] 被称为“奇点时间”或“崩溃时间”。这个 [math]t_c[/math] 的值由以下公式近似得出:
- [math]\displaystyle{ t_{c} \approx \left[\frac{E}{(\beta-1)R}\right]\frac{1}{N^{\beta-1}(0)} }[/math]
然而这种超指数的增长不可持续,因为方程将在有限时间内达到奇点,此时人口趋于无穷大。此时,条件[math]N(0) <{(\frac{R}{Y_{0}})^{\frac{1}{\beta-1}}}[/math]条件可能被触发(例如无限的人口扩张导致每人的平均成本升高),因而城市走向崩溃。为了避免这种情况,城市必然会在此之前就经历“重大质变”,也就是通过创新来“重置”初始条件[math]N(0)[/math]和参数[math]Y_0,R,E[/math],以使得[math]N(0)>{(\frac{R}{Y_{0}})^{\frac{1}{\beta-1}}}[/math]条件得到满足。这种创新活动确保了城市的主导动力仍然处于“财富和知识创造”的超线性增长阶段。历史上,当人类社会发生重大技术的跃迁正可以对应这种情况。这样,为了避免崩溃,城市必须在接近奇点时间 [math]t_c[/math] 时引入新的创新周期。每一次新的创新都有效地重置了增长参数,开启了一个新的超线性增长周期。
重置过程包括两个方面:
- 重置初始条件:调整初始人口规模 [math]N_0[/math]
- 重置方程系数:这是更重要的环节,需要重置系数:
- [math]Y_0[/math]:归一化常数,代表城市的单人产出
- [math]R[/math]:增加一个新个体所需的平均资源量
- [math]E[/math]:维持每个个体平均所需的资源量
历史上,人类社会发生重大技术跃迁时,正是对应这种重置机制。
分阶段超指数增长曲线
当参数重置以后,城市增长便进入了第二轮增长曲线。然而,这一增长曲线也不可持续,在有限时间内仍然会趋近第二个有限时间奇点,于是又会导致[math]N(0) > {(\frac{R}{Y_{0}})^{\frac{1}{\beta-1}}}[/math]条件遭到破坏,于是城市进入第二轮崩塌模式中,这会导致第二轮的变革将会出现,从而重置初始条件和方程系数,于是进入第三波增长曲线,如此往复下去……。
当我们汇总上述情况并推演下去,最终可以得到城市的增长曲线如下图[16]:

这一波浪形的曲线与技术增长的准周期曲线十分相近。
Bettencourt的论文[16]通过纽约市的人口相对增长率随时间变化的观测数据,为上述理论提供量化的实证数据支持(如下图)。

注意该图绘制的并不是人口随时间变化的曲线,而是人口生长率随时间变化的曲线,因而该图与分阶段超指数增长曲线本质上是一致的。
从该图,我们可以得到以下结论:
- 纽约市的相对人口增长率图显示出连续的、加速的(超指数)增长时期。这些超指数增长期被短暂的减速期分隔开来。这种连续加速增长的模式与理论预测的“成功接续的超线性创新周期会重置奇点并推迟不稳定性和随后的崩溃”的机制相符。
- 奇点时间 [math]t_c[/math] 的拟合:针对纽约市不同增长周期起始时的人口 [math]N(0)[/math] 与预测的崩溃时间 [math]t_c[/math] 的关系进行拟合(小图),结果与预测吻合良好。观测数据最佳拟合的 [math]\beta[/math] 值为 [math]\beta \approx 1.09[/math],这与美国城市的幂指数[math]\beta\approx 1.15[/math]接近。
不可回避的奇点
虽然通过重置系数可以暂时避免崩溃并开启新的增长周期,但这一过程是不可持续的。
事实上,从方程(12),以及对有限时间奇点的分析,我们还可以得到一个关键的结论:为了维持持续增长,创新周期之间的时间间隔必须不断缩短。这是因为根据奇点时间公式:
- [math]\displaystyle{ t_c^i \propto \frac{1}{(N_0^i)^{\beta-1}} }[/math]
这里,[math]t_c^i[/math]代表第[math]i[/math]个准周期的周期长度,即达到有限时间奇点的时间长度,[math]N_0^i[/math]则代表第[math]i[/math]个准周期在开始被重置时候的初始人口规模。由此可以推断:当初始人口 [math]N_0^i[/math] 增加时,达到下一次崩溃的时间 [math]t_c^i[/math] 会变短。因此,新的重大创新或适应措施必须以不断增加的速率出现,才能维持城市的增长。
于是,随着[math]N_0^i[/math]持续增长,[math]t_c[/math]必然会变得越来越短。最终当[math]t_c\rightarrow 0[/math]的时候,城市便遭遇了不可回避的奇点(Unavoidable singularity)。在这一点,人们将不能通过重置系数而进入新的增长轨迹[2]。
企业生长方程
既然企业也普遍遵循亚线性的规模法则,而且企业可以类比生物体,因此从规模法则导出生长方程的逻辑同样也适用于企业。但是,与生物和城市不同,企业在生长的过程中还需要考虑另外一个非常重要的因素,这就是债务。由于,企业可以通过借贷的方式而扩张资本,所以负债的规模法则是影响企业生长方程中的关键因素[21]。
张江等人在2021年的研究[21]基于规模法则推导出了符合任意单一市场的企业生长方程。该理论基于企业的财务平衡原理与规模法则,提供了一个描述任意单一市场代表性企业随时间增长的通用方程。
该理论建立在两个基本假设之上:
1. 财务平衡方程: 企业的总资产 [math]A(t)[/math] 随时间的变化率,等于其净收入 [math]I(t)[/math] 加上负债 [math]L(t)[/math] 的变化率。在忽略资本注入和股息支付等次要因素后(通过研究实证数据,这两项与债务增量相比较对于上市企业都是可以忽略的),这一关系可以表达为微分形式:
- [math]\displaystyle{ \frac{dA}{dt}=I(t)+\frac{dL}{dt} }[/math]
此方程在任何时刻都成立,它描述了企业的资源流入和流出如何驱动其增长。该方程称为财务平衡方程。
2. 企业的财务指标均符合总资产的规模法则(如净收入 [math]I[/math] 和负债 [math]L[/math])与公司规模(用总资产,即Total Assets: [math]A[/math]来衡量)之间均存在着幂律关系。这与生物体和城市中观察到的规模法则类似:[math]X(A)=c_{X}A^{\beta_{X}}[/math]。其中 [math]X[/math] 代表某一财务指标,[math]c_X[/math] 为规模法则的常数,[math]\beta_X[/math] 为规模法则的幂律指数。
重要公式推导
通过将规模法则代入微分形式的财务平衡方程,可以得到一个通用的企业增长微分方程,它能预测公司总资产随时间的变化轨迹。
这里,我们主要关注两个规模法则:收入的规模法则[math]I=c_IA^{\beta_I}[/math],以及负债的规模法则:[math]\displaystyle{ L=c_{L}A^{\beta_{L}} }[/math]。代入财务平衡方程 [math]\displaystyle{ \frac{dA}{dt}=I+\frac{dL}{dt} }[/math],得到:[math]\displaystyle{ \frac{dA}{dt} = c_{I}A^{\beta_{I}} + c_{L}\beta_{L}A^{\beta_{L}-1}\frac{dA}{dt} }[/math]
重新整理此方程,得到普适的企业增长率方程(Generalized Growth Equation):
-
[math]\displaystyle{ \frac{dA}{dt}=\frac{c_{I}A^{\beta_{I}}}{1-c_{L}\beta_{L}A^{\beta_{L}-1}} }[/math]
(13)
这个方程描述了企业资产 [math]A[/math] 随时间 [math]t[/math] 变化的速率。
通用增长曲线与近似解
如果将某市场的参数(包括:[math]\beta_I,\beta_L,c_I,c_L[/math]等)代入式(13),则该微分方程的解给出了企业随时间的增长轨迹。通过对该方程进行积分,可以得到一个描述企业资产 [math]A(t)[/math] 与其年龄 [math]t[/math] 之间关系的隐式表达式,该表达式被称为:
通用增长曲线(Generalized Growth Curve):
- [math]\displaystyle{ t = \frac{A^{1-\beta_{I}}}{c_{I}(1-\beta_{I})}[1-(\frac{1-\beta_{I}}{\beta_{L}-\beta_{I}})c_{L}\beta_{L}A^{\beta_{L}-1}] }[/math]
然而,对于一般的情形,这个方程通常无法直接反解出 [math]A(t)[/math] 的显式表达式。当负债的标度指数 [math]\beta_L[/math] 约等于 1 时,可以得到一个很好的近似解:
幂律增长近似解(Power Law Approximation):
- [math]\displaystyle{ A(t) \approx ct^{\gamma} }[/math]
其中,指数 [math]\gamma[/math] 和系数 [math]c[/math] 由幂指数 [math]\beta_L[/math] 和 [math]\beta_I[/math] 决定。当 [math]\beta_L[/math] 近似等于 1 时(例如在美国市场),指数 [math]\gamma[/math] 的表达式简化为 [math]\gamma = \frac{1}{1-\beta_{I}}[/math]。根据美国市场的实证数据,[math]\beta_I \approx 0.85[/math],这导致 [math]\gamma \approx 6.79[/math]。当然,我们也可以通过数值的方式,反解出[math]A(t)[/math]。
总之,该模型表明,公司的增长轨迹是一个复杂的、由其内在财务结构决定的动态过程。与生物体最终停止生长的S形曲线不同,该模型预测企业可以经历类似城市一样的开放式增长,即具有较大幂指数的超线性幂律增长,而且不存在着饱和效应。这种理论框架能够灵活地适用于不同市场(例如,中国、欧洲市场的 [math]\beta_L[/math] 略大于1),并做出准确的预测。
模型的验证
陶如意等人利用美国、欧洲和中国的数据,验证了上述企业生长方程的有效性。
- 美国和欧洲:数据来自Compustat数据库,包含了美国(1950-2023)和欧洲(1987-2023)公开上市公司的财务信息。
- 中国:数据来自Wind资讯的上海证券交易所和深圳证券交易所数据库,包含了1996年至2022年中国公开上市公司的财务信息。


衰老与死亡
上述各种规模法则都是基于代谢率,或者是某种广义代谢率的体现(例如GDP或净收入),与规模(可以是物种的平均体重,或城市的总人口或企业的总资产)之间的幂律关系。而代谢率的高低直接决定了物质、能量、资金等资源在复杂系统中的流动快慢。由于这些物质、能量的流动都伴随着非平衡的过程,因此这些流动必然会导致熵产生的出现。因此,系统可能在代谢的过程中积累大量的熵,从而导致最终的灭亡。因此,规模法则与死亡过程,或复杂系统的存活寿命存在着一定深刻的联系。
生物体的死亡
Brown等人根据新陈代谢的理论推导生物体的死亡规律[24]。由于在大多数种群中,死亡率必须非常接近繁殖率以维持种群稳定,而繁殖率又是由新陈代谢的生物量生产所驱动的,因此死亡率的变化可以通过代谢率来解释。
基础方程:新陈代谢率
首先,Brown等人改写了克莱伯法则的标准形式(式2),引入了与温度相关的指数因子。也就是说,生物的代谢率(B),取决于生物体质量(M)和生物所处环境的平均绝对温度(T)。代谢率的规模法则方程可表为:
-
[math]\displaystyle{ B \propto M^{\frac{3}{4}}e^{-\frac{E}{kT}} }[/math]
(14)
其中:
- [math]M[/math] 代表生物体质量。
- [math]e^{-\frac{E}{kT}}[/math] 是玻尔兹曼-阿伦尼乌斯因子,表示温度的指数依赖性,其中 [math]E[/math] 是活化能,k 是玻尔兹曼常数。
推导生物体的死亡率方程
我们不妨将生物体理解为一个水缸,基础代谢率[math]B[/math]即流入和流出水缸的速率,体重[math]M[/math]即水缸中水的总重量。于是,我们可以问,假如水缸中的水均匀流动,那么在单位时间中(例如一天),水缸中的全部水被更新了多少轮?
这可以通过单位质量的代谢率来计算,即[math]B/M[/math]。根据(14)式,单位质量的代谢率应遵循的方程是:[math]B/M \propto M^{-\frac{1}{4}}e^{-\frac{E}{kT}}[/math]。因此,该理论进一步预测,由于新陈代谢是生物体内所有速率过程的基础,包括决定生长和繁殖的速率,都会与生物体的体重呈现[math]-1/4[/math]的幂律关系。
因此死亡率(Z)也应以与单位质量的代谢率相同的方式进行规模缩放:[math]Z \propto M^{-\frac{1}{4}}e^{-\frac{E}{kT}}[/math]。因此,死亡率的规模法则方程与单位质量的代谢率方程形式上一致,也与生物体质量的 [math]-\frac{1}{4}[/math] 次方成反比,并与环境的维度呈负指数衰减关系,即温度越高死亡率越低。
我们可以通过下图来验证这一规律:

寿命、心率与一生心跳常数
基于同样的水缸模型和克莱伯定律,可以进一步推导出生物体寿命与体重的关系。寿命(L)可以理解为死亡率的倒数,即生物体在单位时间内不死亡的概率累积。由于死亡率 [math]Z \propto M^{-\frac{1}{4}}[/math],因此寿命应与死亡率成反比:
- [math]\displaystyle{ L =c_L M^{\frac{1}{4}} }[/math]
这意味着体型越大的生物,寿命越长,二者呈现1/4幂指数的规模法则。例如,大象的体重约为老鼠的10万倍,根据1/4幂律,大象的寿命应约为老鼠的 [math]100000^{1/4} \approx 18[/math] 倍。实际观测数据与这一预测高度吻合:老鼠寿命约2-3年,大象寿命约60-70年。这里[math]c_L[/math]为该规模法则的系数。
除此之外,心率(f)作为一种重要的生理速率,同样也遵循 [math]-1/4[/math]幂指数的规模法则:
- [math]\displaystyle{ f =c_f M^{-\frac{1}{4}} }[/math]
这意味着体型越大的动物,心跳越慢。老鼠的心率约为每分钟600次,而大象的心率仅为每分钟30次左右。这里[math]c_f[/math]为该规模法则的系数
将寿命与心率相乘,并代入哺乳类动物的规模法则常数,可以得到哺乳类动物一生的总心跳次数(N):
- [math]\displaystyle{ N = L \times f =c_L\cdot M^{\frac{1}{4}}\times c_f\cdot M^{-\frac{1}{4}} =c_L\cdot c_f\cdot M^{0} =c_L\cdot c_f\approx 1.5 \times 10^{9} }[/math]
结论是,不同体型的生物在一生中的总心跳次数约为 [math]1.5 \times 10^{9}[/math] 次,即约15亿次,这是一个几乎恒定的常数(该数值由两个规模法则的系数[math]c_L,c_f[/math]的乘积而定)。无论是寿命仅2年的老鼠,还是能活70年的大象,它们一生的心跳总数几乎相同。这一"生命不变量"深刻地体现了生命过程的内在统一性:所有哺乳动物似乎都在消耗着同样的"生命配额",只是大型动物的配额消耗得更慢而已。
企业的死亡
根据Daepp等人在2015年发表的研究,企业的“死亡”定义为企业从数据库中的消失。这包括了多种情况,其中最常见的是通过并购(mergers and acquisitions)而消失,而不是清算(liquidation)。论文通过对超过25,000家北美上市企业的综合数据库进行详细的生存分析,发现企业的死亡率(或称“风险率”)在很长一段时间内大致保持恒定,与企业的年龄无关。
论文推导的出发点是一个简单的衰变过程模型,该模型假设死亡数量与现有企业数量成正比。
死亡微分方程
在一个非常小的离散时间间隔 [math]\Delta t[/math]内,死亡的企业数量 [math]\Delta N_d(t,T)[/math] 与在时间t内仍存活的企业数量 [math]N(t,T)[/math] 成正比,比例系数为风险率 [math]\lambda(t,T)[/math]:[math]\Delta N_{d}(t,T)=\lambda(t,T)N(t,T)\Delta t[/math]。
当时间间隔趋近于零([math]\Delta t \to 0[/math])时,这个方程可以写成微分形式:[math]\frac{\partial N(t,T)}{\partial t}=-\lambda(t,T)N(t,T)[/math],其中 [math]N(t,T)[/math] 是在观察时间窗口 T 内,在时间 t 仍存活的企业数量。
死亡率、半衰期
当假设风险率 [math]\lambda[/math] 是一个常数时,上述微分方程的解为经典的指数形式:
-
[math]\displaystyle{ N(t,T)=N(0,T)e^{-\lambda(T)t} }[/math]
(15)
这个方程表明,一个企业存活到时间[math]t[/math] 的概率随着时间呈指数衰减。论文的实证分析表明,指数分布能很好地拟合数据。这里[math]\lambda(T)[/math]代表了死亡率,它是随企业年龄[math]T[/math]而变化的。
下图显示的是中国企业的死亡率随着年龄的增长的变化曲线,即[math]\lambda(T)[/math]。

生命都有衰老,因此年龄越大,死亡率越高。如上图,企业与生物类似,也展现出了存活时间越长,死亡率越高的趋势。
由于数据是在一个有限的观察窗口 T 内获取的,为了解决边界条件问题(即在窗口结束时,所有企业都被视为死亡),论文在(15)式基础上引入了一个修正项,即乘以[math]\frac{1-e^{-\lambda(T-t)}}{1-e^{-\lambda T}}[/math]。当观察窗口 T 远大于企业年龄 t 时,这个方程可以近似为常规的指数公式。基于这个模型,论文计算了企业的半衰期([math]t_{1/2}[/math]),即一半的企业死亡所需的时间。可以计算得到半衰期的公式:
- [math]\displaystyle{ t_{1/2}(T)=\frac{\ln~2}{\lambda}[1-\frac{\ln(1+e^{-\lambda T})}{\ln~2}] }[/math]
美国上市企业的平均寿命约为10.2年,而半衰期约为8.6年。这意味着大约9年以后,就会有一半的企业“死亡”。
企业的“心跳”与“寿命”
企业与生物的类比不仅在于它们共同的亚线性规模法则,还在于由这些规模法则推导出的关于类似于”频率“和”寿命“的规模法则和类似的死亡风险曲线。前面已经指出,越大的生物体,由于细胞的新陈代谢率提高,活动频率会逐渐下降,而活动时间会相应增加。所以,大象的心率要比老鼠快得多,但比老鼠的寿命长得多。因此,生物体的各种新陈代谢的快慢和维系时间长短都与其规模呈现规模法则。那么,企业有没有相应的规律呢?首先,我们需要找到企业中与生物心跳频率类似的变量。《规模法则》一书第10章发现,企业的资金周转、人员周转都可以看作是企业的某种代谢速率,可以类比为心跳频率。因此,和生物体非常类似,越大的企业,人员更迭和资产周转的速度越慢,而相关的时间,如企业的平均寿命、员工留在企业中的平均时间也会越长。《规模法则》指出,该规律可以被实证数据验证,如下图所示。

这里的a图为企业的资产周转率随总资产的幂律关系,幂指数为-0.19,其中原始数据按照总资产的数量级进行了小区间的划分,并在每一个区间求平均值,如图中黑点所示。图b为员工离职率随员工数的幂律关系,幂指数为-0.15,故离职率随总资产的幂指数为-0.11。图c为企业平均寿命(在数据集中存在的时间长度)随总资产的幂律关系,其中平均寿命按对数小区间取了平均值,幂指数为0.14。图d为员工在企业中的效力时间随员工数的幂律关系,幂指数为0.11,故效力时间与总资产的幂指数为0.08。其中图b和图d的数据来自文献[25] ,我们将该文献中的表格数据重新画在了双对数坐标系中。
因此,随着企业规模的增大,其对现金流的“新陈代谢”水平明显降低,这体现为其人员更迭和资产周转速度都会逐渐变慢。与之相对的是企业寿命和员工效力时间的增加。这一点让企业与生物体的相似性更显著了。更有趣的是,细致考察幂指数就能发现,它们的数值基本在0.15左右,而这与净收入对总资产的幂指数0.85刚好形成互补,即相加等于1。为什么会有这一现象呢?
《规模法则》指出,我们可以将企业的生长率([math]\Delta A/A[/math])看作企业总资产新陈代谢的速度,而这实际上决定了企业其他方面的代谢速度,包括人员更迭、资产周转等。我们知道,生长率与企业规模呈[math]\beta-1[/math]次幂的关系,对于美国企业来说,这个幂指数就是-0.15,所以,人员更迭、资产周转都会与企业规模呈约-0.15次幂的关系。速率的倒数就是时间长短,因此可以得到有关时间与规模之间的幂律关系,幂指数就应该是0.15,这个幂指数也和实际数据大致吻合。
我们也可以利用推导生物体心跳频率和寿命长短的类似推导,将企业视作一个水缸模型,只不过水缸里面流动的不是水而是现金流。如果我们将净利润与新陈代谢相类比,即每时刻注入水缸中的水流,人员与货币的周转类比为生物体中血液的周转,那么不难推导出,净收入与总资产之间的0.85次幂这一广义的克莱伯定律,蕴含了企业人员更迭、资产周转速度的近似-0.15次幂(类比为心跳频率),和存活/停留时间的0.15次幂(类比为寿命长短)。
解释模型
普遍存在的规模法则,特别是以复杂系统中的广义新陈代谢为基准的规模法则,实际表达了一种复杂系统与环境之间的能量、物质交换与复杂系统自身的能量物质总存储量之间的非线性关系,即一种广义的流与存的关系。这进一步促使人们思考是否存在着复杂系统中某种普遍的机制从而导致了规模法则?一个普遍的观察是,所有复杂系统都是由大量的输运能量或物质的网络构成的,那么普遍存在的规模法则是否是这类网络的普遍特性的反映呢?
然而,我们也应该看到,不同的复杂系统所展现出来的广义新陈代谢的规模法则也存在着显著的差异,这主要体现在其幂指数的明显不同。例如,对于生物体和企业来说,幂指数普遍小于1,呈现出一种亚线性的规模法则,而对于城市复杂系统,则幂指数大于1,呈现出超线性的规模法则。因此,下面我们将分生物、城市和企业,分别论述各自的基于网络的解释模型。
生物规模法则:克莱伯定律的解释模型
克莱伯定律是生物学中最著名的规模法则之一。它指出生物的基础代谢率 [math]\displaystyle{B}[/math] 与体质量 [math]\displaystyle{M}[/math] 呈现四分之三幂律关系:[math]\displaystyle{ B = B_0 M^{3/4} }[/math]。其中 [math]\displaystyle{B_0}[/math] 为常数。
生命的第四维
如果我们假设生物体为一个生活在三维空间中几何体,并且靠它的表面积进行自身与环境的物质能量交换,也就是新陈代谢,如果生物体的体重[math]M[/math]正比于其三维几何体的体积,且新陈代谢率[math]B[/math]正比于其表面积,那么必然有[math]B\propto M^{2/3}[/math],这便是早在19世纪模型,生物学Rubner便给出的一个解释生物体代谢率与体重关系的解释模型。然而,这个幂律指数是2/3,而不是3/4,因此并不能解释克莱伯定律。
人们进一步猜想是否生物体可以被看作是一个四维空间中的几何体,但这多出来的一个维度究竟怎解释呢?1999年,West等人在Science上发表文章[26],指出这是来源于分形几何,而且是最大化的分形,从而导致本来是三维的几何体的生命,却多出来了一个额外的维度。下面,我们详细解读该模型。
理论背景与核心思想
为了解释 [math]3/4[/math] 的幂律指数的起源,物理学家杰弗里·韦斯特 (Geoffrey West)、生态学家詹姆斯·布朗 (James Brown) 和布莱恩·恩奎斯特 (Brian Enquist) 提出了“生命的第四维”这一概念[26]。
生命的第四维的核心观点是,生物体为了在有限的三维体积内最大化物质与能量的交换效率,其内部负责新陈代谢的关键表面(例如循环系统的血管网络、呼吸系统的肺泡、消化系统的肠道等)演化出了高度褶皱和扭曲的分形结构。这种分形几何特性使得一个二维的表面能够有效地填充三维空间,从而使其维度从欧几里得维度2提升至分形维度3。
从三维到四维
West等人的论证逻辑是这样的:
- 生物体一般包含有两种表面:一种是外部的表面,它通常是一个欧几里得曲面(即没有过多的褶皱),例如皮肤,其面积与体积的关系遵循经典的[math]2/3[/math]次幂法则。另一种表面则是生物体内部的表面,这些表面通常具备分形特征,也就是表面会充满了复杂的褶皱,这种表面往往才是生物体完成代谢交换的关键,例如我们的肠道、血管和肺泡网络。
- 内表面的空间填充特性:通过进化,这些内表面被最大程度地“褶皱”和“分形化”,以至于它们几乎能以一种二维的平面填满其所在的三维空间。一个典型的例子是,人类肺部的总表面积相当于一个网球场大小,而循环系统中所有血管的总长度可绕地球2.5圈,它们都通过尽可能最大化地褶皱、弯曲,以使得它们被压缩在有限的身体体积内 。这种结构类似于Koch曲线,这是一条维度为2的线却可以填满一个二维平面,因而达到了最大化分形(也就是在所有二维空间中的曲线中,它的维度是最大的)。因此,生物体内的代谢交换表面,其有效维度接近3。
- 第四维的引入:生物体的整体“体积”可以被看作是这个维度为3的内表面面积与一个一维特征长度(例如,从心脏到毛细血管的血液输运距离,或从树根到树叶的距离)的乘积。这样,一个三维的面积乘以一个一维的长度,便构成了一个四维的几何体。这个额外的维度并非传统意义上的时间或空间维度,而是由分形结构和物质流动共同创造的有效维度。
- 几何关系:如果将生物体视为一个内表面最大化分形的嵌入在三维空间中的几何体,那么,其三维的“内表面积”(在此即为代谢率的代理)与四维的“体积”(在此即为生物体质量的代理)之间的关系恰好满足 [math]3/4[/math] 的幂律关系。同时,平均输运代谢物质的时间近似正比于体内管道的平均长度,这一时间长度(如寿命)与这个四维体积之间也呈现 [math]1/4[/math] 的幂律关系 。
WBE模型
然而,上述解释是非常宏观而忽略了很多细节,特别是起到关键作用的输运网络的细节性质并不能从该模型中导出。事实上,最早的一个成功解释克莱伯定律的模型被称为WBE模型[27],它是该文三位作者的姓氏West、Brown和Enquist的首字母为命名的。这是一个以建模生物体中普适的输运网络为基础的模型。该模型从若干假设出发,推导了一种层次化的分形输运网络,并利用该网络上流量分布的性质推导出宏观的生物体必然遵循克莱伯定律这一结论。
WBE网络
早在“生命的第四维”这一概念性框架提出之前,韦斯特、布朗和恩奎斯特于1997年在《科学》杂志上发表了更为严谨和具体的数学模型,即WBE模型[27]。该模型的核心是将生物体内的资源输运系统,如动物的血管网络、植物的维管系统乃至细胞内的微管,抽象为一个最优化的分形分支网络[18]。
该模型基于三个假设:
- 分支网络充满生物体的整个三维空间:输运网络以分形树状结构分支,最终均匀地充满生物体的整个三维内部空间,确保为每一个细胞提供营养物质的输运服务。这意味着网络的末梢能够触及到生物体的每一个角落。
- 毛细血管等末端单元大小基本恒定:网络的最小单元,如毛细血管、植物叶脉末梢或细胞内的微管,其尺寸和生理特性不随生物体的整体规模变化而改变。例如,大象和老鼠的单个细胞大小,或毛细血管大小基本相同。
- 能量最小化:网络经过数十亿年的自然选择的优化,能够以最小的能量消耗来输运营养物质。为减少血液流动脉冲在血管分叉处的回波和能量损耗,网络需遵循“面积守恒”原则。即每次分叉时,上游管道的横截面积约等于所有下游管道的横截面积之和。这体现了输运过程中的阻抗匹配。
在这些假设下,网络的几何参数在层级之间呈现规律性的缩放。血管的长度、半径和数量在不同层级之间形成几何级数变化。尤其是血管半径满足如下缩放关系:
- [math]\displaystyle{ \frac{r_{k+1}}{r_k} \propto n^{-1/2} }[/math]
其中 [math]n[/math] 为分叉数,[math]r_k[/math]代表第[math]k[/math]层级的血管半径大小。这种分支规律保证了运输网络在三维空间中能够均匀地覆盖整个生物体。
通过进一步推导,我们可以得到生物体质量 [math]\displaystyle{M}[/math] 与网络总体积成正比,而代谢率 [math]\displaystyle{B}[/math] 与末端单元的总横截面积成正比。由于末端单元大小保持恒定,因此随着生物体体型增加,末端单元数量的增加决定了交换面积的扩展速率。最终,综合这些缩放关系,模型导出了:
- [math]\displaystyle{ B \propto M^{3/4} }[/math]
这一结论不仅重现了克莱伯定律,还对许多与代谢相关的生理特征做出了可检验的预测,例如血流速度、动脉血压与体型的关系,以及血管长度和半径的缩放模式等等[18]。大量实证研究表明这些预测与实际数据高度一致,因此 WBE 模型成为解释生物代谢缩放规律的最具影响力的理论框架之一。

输运网络模型
WBE模型虽然解释力度很强,但是模型略显复杂,引入的假设也比较多,而且生成的网络模型非常规则。这些不足促使更多的人提出更多的输运网络模型,该模型从一组更简单的假设出发,将生物体视为一个高效(最优)的物质运输系统,而不局限于特定的分形几何结构。进一步,Dreyer等人将Banavar网络的结构特征进一步泛化到流场之中,从而提出了Dreyer球模型。这部分我们将分别从Banavar 模型和Dreyer模型出发来介绍他们的研究。
Banavar, Maritan和Rinaldo于1999年在Nature上发表文章,提出了Banavar最优输运网络模型,用以建模生物体内部的输运网络(例如动物的心血管和呼吸网络植物的经脉网络和根系统,以及细胞的微管网络等),从而解释克莱伯定律的起源[28]。该文章认为,自然界中的分布式网络源于有效连接的需要,既存在于生物系统中,也存在于无机系统中,如河流流域的排水网络。他们推导了任意网络中大小和流率之间的一般关系,并提供了一个统一的框架来解释克莱伯定律。

如上图所示,Banavar等人将生物体建模为一个[math]D[/math]维空间中均匀分布的单一源的输运网络。
网络中每个节点为生物体内的一个抽象的代谢单元(例如一个需要新陈代谢的单个细胞或血管网络的分叉节点),连边对应为链接这些单元的输运关系,连边上的权重对应为流量的大小。网络中有一个唯一的源节点(图中编号为0的节点),这代表了能量或物质流的流入(例如心脏或根)。模型假设上亿年的进化已经让生物体内的输运网络变得输运效率是一种最优的结果,而这种最优的输运网络恰恰可以导出代谢率与生物量尺寸之间的3/4幂律关系。
因此,Banavar模型将克莱伯定律的起源问题转化为一个数学上的最优化问题。它首先定义输运网络的优化目标为总输运成本:
- 优化目标:总输运成本[math]C=\sum_{ij}f_{ij}[/math],这里[math]f_{ij}[/math]为任意i到j的连边的流量,[math]C[/math]越小网络效率越高。
同时,整个网络需要受到下面的一系列约束:
- 每个代谢单元的单位时间内的能量消耗为常数1单位,即第[math]i[/math]个节点的耗散流(即i到环境的流量)[math]D_i=1[/math];
- 整个网络处于流量平衡的稳态(即所有节点的入流都必须等于出流),即对于任意节点[math]i[/math],有[math]\sum_{k}f_{ki}=\sum_{j}f_{ij}+D_i[/math],这里[math]f_{ij}[/math]代表从i到j的流量;
- 网络的连接必须是局部的;
- 节点的分布在[math]D[/math]维空间必须是均匀的;
- 源节点是一个特殊的节点,它承载了所有的从环境输入的流量。
在这样的约束条件下,显然不同的网络连接结构就会对应不同的网络输运成本[math]C[/math],如上图a或b;有的网络输运成本低(如图c),有的则成本很高(如图d)。
Banavar定义了一个重要的中间变量,可以帮我们计算任意网络的输运效率,即[math]L_X[/math]:任意节点到源的网络距离。上图中所有节点中间的数字即为该节点的[math]L_X[/math]。Banavar等人证明,所有节点上的[math]L_X[/math]之和即为该网络的总输运成本。对于D维空间中的网络,他们证明了一个关键定理:[math]\displaystyle{ C \geq L^{D+1} }[/math],这里[math]L=\frac{\sum_X L_X}{N}[/math],[math]N[/math]为节点总数。因此,最优的输运网络正比于每个节点到源的平均距离的[math]D+1[/math]次幂,这种最优网络结构如图c所示,相反,他们也找到了一种最高成本的网络,输运成本为[math]C\propto L^{1/2}[/math],这种成本最高的网络如图d所示。
最后,Banavar等人将网络的整体指标对应到生物体的新陈代谢和体重上。具体地:
- 生物体的新陈代谢[math]F[/math]正比于从源流入的总量,也正比于节点总数[math]N[/math],(由于每个节点的耗散为1单位,而且流量平衡),也正比于这些节点占据的[math]D[/math]维空间中的体积(因为节点均匀分布)。因此,我们可以得到[math]F\propto L^D[/math]。
- 生物体的体重规模[math]M[/math]正比于总输运成本[math]C[/math],在最优的情况下,它可以达到[math]C\propto L^{D+1}[/math](由文中定理)。
因此,我们可以得到,对于最优的输运网络,我们有[math]F\propto M^{D/(D+1)}[/math],如果取[math]D=3[/math],我们便解释了克莱伯定律的起源。
不仅如此,他们的理论还预测,该模型同样适用于河流流域的排水网络。对于有效流域的排水盆地(drainage basin),每个节点的流入流量正比于该节点为根的子树的面积[math]A_i[/math],总的输运成本正比于该子树上所有流入流量的总和,即[math]C_i=\sum_{j\in T_i}A_j[/math],这里[math]T_i[/math]代表以i为根的子树的节点集合。于是,我们可以得到[math]A_i[/math]与[math]C_i[/math]的幂律关系,且幂指数为2/3(这是因为[math]D=2[/math])。
尽管该模型与WBE相比,在具体细节上变化很大,但内置于高效运输网络中最优效率却为不同的流网络系统提供了统一的解释框架。他们的分析显示基本结果不需要关于网络分层性质的任何假设,也不一定需要树状结构。然而,树的存在会大大缩短网络的总长度,从而增加其可行性和效率。
Dreyer模型
Dreyer (2001) 在 Banavar 的基础上提出了中央源系统的异速标度律。他指出,流量与存量的幂律关系在自然界中大量存在,包括动植物代谢率与其质量的幂律关系,以及河流流域大小与其所含水量总量的幂律关系[29]。
河流流域(drainage basin)可以看作是一个中心源(从上游河流流入流域的流量)输运网络,其中每个单元都是一个耗散单元,以均等的速度丧失流量。因为这是一个[math]D=2[/math]的网络,因此,该流域的大小A和河流中包含的水的总量[math]C[/math]满足:[math]\displaystyle{ A = A_0C^{2/3} }[/math]。

同样的道理,对于[math]D=1[/math]的流网络,也应该存在流量和存量之间的1/2幂指数的幂律关系。文献[29]提出了一个简单实验(如右图),验证了流量与存量之间的关系[math]F\propto M^{D/(D+1)}[/math]同样适用于一维的流系统。在该实验中,作者构造了一个水槽,水槽底部均匀地分布着小孔可以漏水。另外,水源从水槽的一段注入,注入的流量为[math]F[/math]正比于水槽的长度[math]L[/math]。水从一端注入,逐渐由小孔渗出,水量越来越少。最终,从水流的注入到最后刚好没有水的地方长度为[math]L\propto F[/math],而水槽中的总蓄水量为[math]M[/math],[math]M[/math]和长度[math]L[/math]满足以下关系:[math]\displaystyle{ L = L_0M^{1/2} }[/math]。所有这些例子中的幂律指数都具有[math]\displaystyle{ D/(D+1) }[/math]的形式,其中[math]D[/math]是系统的空间维数。
Dreyer论证到,任何的中央源的流场,且该流畅满足连续性和流动的守恒性,则该流量场的缩放满足如下规律:
- [math]\displaystyle{ \nabla \cdot s \mathbf{j}\left(\frac{\mathbf{r}}{s}\right) = (\nabla \cdot \mathbf{j})\left(\frac{\mathbf{r}}{s}\right)=\sigma(\mathbf{r}/s) }[/math]
这里流场矢量为[math]\mathbf{j}[/math],场源强度为[math]\sigma[/math],流场中任意位置向量为[math]\mathbf{r}[/math],对流场的缩放倍数为[math]s[/math]。可以证明,流量场在满足如上式的缩放关系的情况下,整个流场就一定具备幂指数为[math]\displaystyle{ D/(D+1) }[/math]的流入量与总流量的规模法则[29]。
与Banavar网络模型相比,Dreyer的中央源流场模型本质上与Banavar等人给出的最优输运网络是一致的,前者是最优输运网络的连续版本,而最优输运网络则是中央源流畅的离散版本。然而,Dreyer的模型显然更加简洁、自然,它可以用更少的假设解释这里讨论的规模法则。结果的一般性与幂律的广泛有效性很好地共鸣。
其他
Glazier (2014) 回顾并综合了关于代谢率与系统大小的规模法则,因为单一模型无法解释复杂的代谢率的规模法则,因此他提出了情境多模态理论(Contextual Multimodal Theory, CMT)[30],作为对单一机制模型的补充与整合。CMT 强调,代谢率相关规模法则并非由某一个固定的物理约束决定,而是受到不同生物学机制和环境因子的共同影响。该理论将现有解释框架归纳为四个主要模块:表面积模型(SA)、资源运输模型(RT)、系统组成模型(SC)和资源需求模型(RD)。不同情境下,这些模块的相对作用权重会发生变化,从而导致幂律指数 [math]\displaystyle{b}[/math] 在不同范围内波动(通常在 [math]\displaystyle{2/3}[/math] 到 [math]\displaystyle{1}[/math] 之间)。
城市规模法则
城市规模法则揭示了城市变量与人口规模的非线性关系:基础设施通常呈亚线性规模法则,社会经济产出与创新表现为超线性规模法则,个体需求相关的变量则呈现近线性规模法则。其中最关键的规模法则是城市GDP与人口的超线性规模法则,而且幂指数普遍落在1.15左右。除此之外,以城市街道为代表的基础设施普遍呈现出亚线性的规模法则,例如城市街道总长度与人口呈现幂指数为0.87左右的亚线性规模法则。这些规模法则的普遍存在,预示着城市的生长满足普适的规律,为了揭示这些规律,人们提出了各种解释城市规模法则的模型。
贝当古城市模型
贝当古(Bettencourt)城市模型是由原圣塔菲研究所的学者Luis Bettencourt于2013年提出的模型[31],它包含了比较宏观的概念模型(从基本的量纲分析和平均场近似推出最基本的规模法则),也包含一个类似生物系统WBE模型的城市层次化网络模型(包含较强的城市路网层次化分级假设,可以推出多个宏观指标的规模法则)部分,旨在解释城市规模标度律背后的普适机制,关于该模型的详细讨论,可参考:[32]。
城市规模标度律的基本模式
城市规模标度律通常表示为 [math]\displaystyle{ Y = cN^{\beta} }[/math],其中 [math]\displaystyle{Y}[/math] 为城市属性,[math]\displaystyle{N}[/math] 为人口,指数 [math]\displaystyle{\beta}[/math] 决定了标度类型。实证表明,城市的属性分成三类:第一类是与社会交互相关的属性,表现为超线性增长([math]\beta\approx 1.15[/math]),包括城市GDP、专利数量、新企业创建数量、研发人员数量、犯罪率、艾滋病例数等。这意味着城市规模每增加一倍,这些属性的增长会超过两倍,体现了大城市在经济和创新方面的显著优势;第二类是与物理基础设施相关的属性,呈现亚线性增长([math]\beta\approx 0.85[/math]),如道路总长度、加油站数量、电力线路长度等。这表明大城市能够更高效地利用基础设施,实现规模经济效应;第三类是与个人或家庭需求直接相关的属性,基本上与人口成线性关系([math]\beta\approx 1.0[/math]),包括住房数量、家庭用电量、用水量等。
模型的核心与理论基础
贝当古模型的关键来自于对实证数据的深入观察和理解:基础设施相关指数(约0.85)与社会产出相关指数(约1.15)之和近似等于2。这一规律意味着人均基础设施与人均产出的乘积保持为一个规模无关的常数:
[math]\displaystyle{ \frac{A_n}{N} \cdot \frac{Y}{N} = G }[/math]
这个约束条件,即常数[math]G[/math]揭示了城市发展中一个根本性的权衡关系:城市的物理空间(基础设施)与社会交互空间之间存在内在张力。社会互动越密集的城市,其人均可用的物理基础设施就越有限;反之,基础设施人均占有量较高的城市,社会交互的强度相对较低。这种权衡关系不仅解释了为什么大城市居民通常面临更拥挤的居住环境和更高的生活成本,也说明了为什么他们能够获得更多的经济机会和创新资源。
宏观概念性模型
首先,Bettencourt在文章[32]中提出了一个宏观的概念性的模型,他大胆假设城市是一个类似于供人们发生相互作用的大的容器,并假设该容器中的人们已经充分混合,这些人与人的互动是沿着城市道路网络而进行的,它们产生的相互作用就转化形成了城市的GDP。因此,根据简单的平均场近似以及量纲分析等方法,他得出了最基础的规模法则,包括城市面积、GDP的规模法则等。
具体地,Bettencourt的宏观概念城市模型的建立可以被概括为两个递进的步骤:
第一步:无组织的定居模型:这是一个对城市高度抽象、简化的假设起点,该模型认为人口在城市空间内随机分布,城市可以类比为一个大的反应容器,移动的人类比为理想气体中的分子可以自由移动。在这个情景设定下,城市中没有道路,因此城市的整个二维空间区域都可以作为人与人互动的场所,而人与人的互动进一步转化为GDP(即假设GDP正比于单位时间内人与人相互作用的次数)。由此,从这几个假设,Bettencourt推出城市面积[math]A[/math]与人口[math]N[/math]的关系为[math]A \propto N^{2/3}[/math],社会产出为[math]Y \propto N^{4/3}[/math]。虽然这个版本过度简化了现实情况,但它导出了最基本的规模法则。
第二步:对上述模型进行进一步的精炼,Bettencourt引入了道路网络,并假设人们沿着道路移动和相互作用。Bettencourt提出了城市组织的四条基本原则:(1)人口充分混合原则,假设每个居民都能通过移动到达城市的任意地点;(2)网络增长原则,假设基础设施网络随人口增长而扩展;(3)有限社会能力原则,该原则约束了个体在移动和交互上的投入;(4)社会经济产出比例原则,该原则将社会交互转化为经济产出。在这些原则约束下,模型得到了更符合实际的结果:城市道路面积[math]A_n \propto N^{5/6}[/math],社会产出[math]Y \propto N^{7/6}[/math]。
至此,Bettencourt已经得出了最基本的规模法则,即道路面积的亚线性规模法则,以及GDP的超线性规模法则,且二者的幂指数之和等于2。
层次化道路网络模型

在上述宏观概念模型的基础上,Bettencourt进一步引出更多具体的假设,从而推导出更多的规模法则。这又分成了4个步骤:
- 第一步:层级网络模型。这是改进模型的最核心假设,它将城市道路网络建模为具有 [math]h[/math] 个层级分形的层级树状结构(如上图)。网络的每一层都有不同的分支数 [math]b[/math](即高层级与低层级单元的数量比),越高层的道路越宽、覆盖范围越大,即宽度[math]s_i[/math] 和长度 [math]l_i[/math] 越大,但是数量会越少;越低层的道路越窄、更加密集,即宽度 [math]s_i[/math] 和长度 [math]l_i[/math] 越小,但道路数量越多。在各个分支处,网络满足一系列基本约束,模型假设:1) 最小单元的宽度 [math]s_h[/math] 与城市规模 [math]N[/math] 无关;2) 网络必须“空间填充”,即总长度 [math]L_n\approx A/l[/math](其中 [math]A[/math] 为城市面积,[math]l[/math] 为特征长度)。通过这些约束,该模型可以精确计算出各个层级道路的长度、面积、流量密度等指标,并得到道路总长度[math]L_n \propto N^{2/3}[/math]和道路总面积[math]A_n \propto N^{5/6}[/math]的规模法则(这里[math]N[/math]是城市人口规模),与宏观模型的预测一致,并为后续分析提供了结构基础。
- 第二步:城市能耗与效率评价。进一步,Bettencourt通过借鉴生物学中新城代谢的规模法则的思路,引入了能量流和阻抗的概念来分析城市的运行效率。他将人员、货物、信息的流动视为网络中的“电流” [math]J[/math],并假设单位长度的电阻 [math]r[/math] 为常数。通过层级的电流守恒 [math]J_i=s_i\rho_iv_iN_i[/math] 和速度/密度缩放关系,可以计算出每个层级的电阻 [math]R_i[/math] 和能耗(功率耗散)[math]W_i[/math]。对全部层级求和得到城市总能耗 [math]W[/math],其规模为[math]W\propto N^{1+δ}=N^{7/6}[/math],具有与社会产出相同的幂指数。这使得城市效率比[math]Y/W[/math]成为一个规模无关的指标,为城市规划和政策制定提供了量化的评价标准。
- 第三步:更多变量的规模法则。利用上述已推导出的基本规模法则([math]L_n \propto N^{2/3}[/math],[math]A_n \propto N^{5/6}[/math],[math]W \propto N^{7/6}[/math]),并通过经济学原理(如地租反映可达性与集聚经济)推导,Bettencourt预测了其他城市变量的规模法则,包括城市地价(rent price)的规模法则,例如平均土地租金的规模法则为[math]Rent\propto N^{1/2}[/math]等。这揭示了城市规模对土地价值影响的量化规律。
- 第四步:最优的社会互动产出参数G。在贝当古城市模型中,他引入了一个关键参数[math]G=\bar{g}a_0\ell[/math],它综合反映了人均社会互动产出强度 ([math]\bar{g}[/math])、互动范围 ([math]a_0[/math]) 和移动距离 ([math]\ell[/math]),本质上是衡量“单位基础设施支撑下所能产生的社会经济互动量”的效率参数。该参数衡量了社会经济效率。模型显示,城市的净收益 [math]L[/math] 可表达为社会总产出 [math]Y[/math]与总能耗成本 [math]W[/math] 之差,并受混合条件与网络条件约束。通过最大化净收益 [math]L[/math],我们可以求解出最优的 [math]G^{*}[/math]。理论预测 [math]G^{*}\approx G_{\max}/8[/math],其中 [math] G_{\max}/8[/math]是城市不至于因拥堵成本过高而解体的上限。美国大多数都市区(MSA)的实测 [math]G[/math] 值聚集在最优值附近,但存在明显偏离的案例:如加利福尼亚州河滨市(Riverside)和得克萨斯州布朗斯维尔市(Brownsville)的 [math]G[/math] 值偏低,这表明其社会互动潜力和基础设施效率未充分发挥;而康涅狄格州布里奇波特市(Bridgeport)的 [math]G[/math] 值偏高,可能面临高昂的交通能耗成本。因此,参数 [math]G[/math] 及其与最优值的偏离,为诊断城市发展效率、评估规划政策(如调整密度、提升交通能效)提供了具体的理论依据和量化靶点。
匹配生长模型
贝当古模型虽然能够成功复现城市中的各类规模法则,但是它仍有如下缺陷:1、原始模型基于平均场假说,难以建模城市中各元素的空间分布特征,特别是分形特征;2、层级化路网模型的引入虽然解释了各种规模法则,但是该模型基于规则分叉的层级化网络,过于理想化而不能模拟路网的分形特征。基于此,李睿琪、董磊等人提出了应用于城市生长的匹配生长模型(matching growth model)[33]扩展[34],从而很好地解决了这两个问题。
原始的匹配生长随机几何图模型是张江等人提出的一种揭示复杂系统的生长过程中,普遍存在的两类规模法则:相互作用的超线性规模法则和多样性的亚线性规模法则,以及生长过程中的加速效应,并用于从唯象的角度解释城市系统,生态网络、文献引文网络、网络社区等多种复杂系统的演化规律[35]。
李睿琪、董磊等人后将该模型进行扩展[34],特别是加入了空间吸引机制,从而使得扩展的模型可以模拟城市的生长和交通路网的形成。该模型还能够解释人类社会经济交互的空间分布特征,特别是预测出活跃人口、道路网络,以及社会经济交互数据的分形维数,还可以复现这些指标的总体规模法则。
基础模型
匹配生长模型假设了一个单调的网络生长过程(也就是说系统中的节点和连边都只能增加,而不能减少),以模拟任何具有个体交互特征的复杂系统的生长过程[33]。其次,模型假设网络中的所有节点都可以被嵌入一个欧氏空间中,并且每一个节点具有一个欧氏空间坐标(该空间可以是城市的地理空间,也可以是节点的某种抽象特征的空间)。再次,模型假设任意两个节点的相互作用是局部的;最后,只有能够与现有节点Q发生相互作用(即满足[math] |x_P - x_Q| \le r[/math])的新增节点P才能存在下去,这里[math]r[/math]为模型中的唯一参数。
下图展示了一个二维的匹配生长模型的生长过程,其中每一个圆盘中心对应为一个节点,圆盘对应为每个节点的相互作用范围。圆盘随机地生成(新圆盘坐标服从二维空间的均匀分布),新的圆盘只有与一个已有的圆盘重叠的时候(匹配),才能有效地生长。有效生长后(达到了匹配),新节点会和其对应圆盘范围内的所有节点建立新的连接。

如果我们将该生长网络的节点数量记为[math]N[/math],连边数记为[math]Y[/math],所有圆盘覆盖的面积记为[math]D[/math],则三个变量服从如下规模法则:
- [math]\displaystyle{ E\propto N^{\frac{d+2}{d+1}} }[/math]
- [math]\displaystyle{ V\propto N^{\frac{d}{d+1}} }[/math]
- [math]\displaystyle{ t\propto N^{\frac{1}{d+1}} }[/math]
这三种规模法则可以模拟普遍存在于各类复杂系统中的相互作用的超线性规模法则,和多样性的亚线性规模法则,其中[math]N[/math] 表示系统的规模,[math]E[/math] 表示系统中的连边数,即系统中的相互作用,[math]V[/math]表示节点圆盘的覆盖区域的面积,可以建模系统中节点的多样性水平;[math]t[/math] 代表整个网络的生长周期(总共产生了多少个随机点,也包括无效生长的点),[math]d[/math]代表空间维度,在二维空间中,[math]d=2[/math]。
这里面的第一个式子,模拟了相互作用的超线性规模法则,其中幂律指数[math]\alpha =\frac{d+2}{d+1}>1[/math];而第二个式子则模拟了多样性的亚线性规模法则,其中节点圆盘的覆盖面积对应为节点的多样性,这一亚线性规模法则的幂律指数为[math]\beta=\frac{d}{d+1}<1[/math];第三个式子则模拟了很多复杂系统之中普遍存在的加速生长现象,即系统规模的增长速度会随着系统的存活时间变长而变快,这一规律可以反映为时间与规模的亚线性规模法则,其中幂指数[math]\gamma=\frac{1}{d+1}[/math]。
进一步,为了模拟、解释城市、在线社区等实际生长现象,特别是形成的幂指数应保持与实际观测的幂指数接近一致,该模型还引入了“拥挤机制”(体现为一个新节点在某处的实际“存活”除了考虑临近匹配规则之外,还会以正比于 [math]\rho(x)^{-\theta}[/math] 的概率成功“存活”,其中 [math]\rho[/math] 为x点处的节点密度,幂指数 [math]\theta[/math]为引入的参数,刻画了新节点加入的概率对已存在节点密度,即拥挤程度的敏感性[33]。在这一机制引入之后,模型便可以得到新的规模法则:
- [math]\displaystyle{ E(t)\propto N(t)^{1+\frac{1}{(1+\theta)d}} }[/math]
- [math]\displaystyle{ V(t)\propto N(t)^{\frac{(1+\theta)d}{1+(1+\theta)d}}. }[/math]
即连边的超线性规模法则和多样性的亚线性规模法则的幂指数都会随着[math]\theta[/math]的变化而变化。当 [math]\theta[/math] 增大时,系统增长趋于线性。研究表明,超线性与压线性规律源于同一几何约束机制:活动密度增加压缩空间体积,从而使系统在增长过程中同时表现出交互加速与多样性减缓的“几何匹配”特征。
有趣的是,该模型还预言,无论维数[math]d[/math]和参数[math]\theta[/math]是多少,幂指数都满足:[math]\alpha+\beta=2[/math],即相互作用的超线性规模法则和多样性的亚线性规模法则二者之间存在着一个相互制约的约束关系,这也可以反映社会分工的多样性与社会连接度的此消彼长的关系。详细信息可以参考:匹配生长模型以及专著《规模法则》[18]。
扩展到城市生长模型
2017年,李睿琪、董磊等人在文献[34]中改进了匹配生长模型,引入了空间吸引机制,使得模型可以模拟城市的生长行为,并解释城市系统中的规模法则,以及城市内部人口、道路和社会经济互动的空间分布及其背后的分形规律。他们认为,城市不仅是人口的聚集,还包括道路与互动网络的协同演化,这三者遵循统一的空间标度框架[34]。
引入空间吸引机制的匹配生长模型
模型的核心思想是:新形成的“活跃社区”(active population, AP)在空间上按照一定概率出现,其位置受现有人口密度与无人空间区域吸引力的共同作用。形式上,新节点在位置 [math]\displaystyle{(r,\theta)}[/math] 出现的概率为:
- [math]\displaystyle{ P(r,\theta,t) \propto \rho(r,\theta,t) + C }[/math]
其中 [math]\displaystyle{\rho(r,\theta,t)}[/math] 为局部人口密度,[math]\displaystyle{C}[/math] 表示无人空间区域的吸引强度,它是一个可以调节的正的实数,这是该模型中除了空间维数以外唯一的一个参数。当 [math]C[/math] 较大时,新生成节点会比较均匀地分布不受已有节点密度的影响;当 [math]C[/math] 比较小的时候,则新生成的节点会以较大的概率在已有节点附近生成。同样的,当新节点距离现有节点过远时,因连接成本过高而无法存活,这就是“匹配生长”机制。将空间吸引机制与匹配生长机制结合,就可以使得我们可以用 [math]C[/math] 调节最终生成的节点分布情况。
活跃人口分布
在城市建模中,作者们认为,引入了空间吸引机制后的匹配生长模型可以建模城市中活跃人口的分布情况。所谓的活跃人口,是指城市中某一个空间点处生活或工作的长期平均人口,通常可以用此点处的工作人口和居住人口按照工作/休息时间比例混合平均来进行估计。这种人口密度可以比一般的居住或工作人口密度更好地刻画人口在城市中的分布,并且更符合匹配生长模型的预测。下图展示的就是真实与用匹配生长模型模拟的伦敦市的活跃人口的分布情况:

模型生成的节点示意图
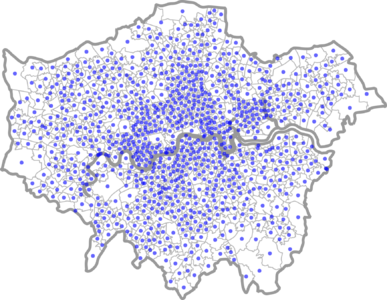
伦敦区域匹配增长空间吸引模型结果


道路生长机制
为了模拟道路的生长,该模型引入的第二个假设就是某一块区域的道路密度是依赖于该区域的活跃人口密度的。由于城市道路的分形特征,道路网络近似可以被看作是用一个一维的线来填充充实一个二维的城市平面区域,因此,一块小区域中的道路总长度满足:
- [math]\displaystyle{ l(x,t)\propto \rho(x,t)^{1/2} }[/math]
这里,[math]\displaystyle{ x }[/math] 城市中某一点的位置坐标,[math]\displaystyle{ t }[/math] 是时间步,[math]\displaystyle{ l }[/math] 是这片区域中道路的长度,[math]\displaystyle{ \rho }[/math] 是该区域中活跃人口的密度。很多道路生成模型都满足该机制。
社会交互机制
为了模拟城市中社会经济互动的分布规律以及规模法则,该模型引入的第三个假设是某一区域的社会经济互动是依赖于该区域的活跃人口密度,以及道路的长度的。如果我们设某一个区域内的社会经济活动的总量为[math]\displaystyle{ g(x,t) }[/math],那么它满足:
- [math]\displaystyle{ g(x,t)\propto \rho(x,t)\cdot l(x,t) }[/math]
在城市中,道路可以被看作是人与人交互的界面。我们可以观察到,很多的商铺都是沿着道路开设的,而这些商铺都是人与人交互的场所。所以,一块儿区域的道路越多,则社会交互也会越多;交互的主体是人,因此一块儿区域人口密度越高,则社会交互也会越密集。因此,局部的社会交互是正比于局部的人口密度和道路长度的乘积的。
空间幂律
由上述三种引入的机制和匹配生长规则,我们便可以模拟一座城市的生长,包括道路网络的生长和社会交互活动的增加。而且,该模型可以从理论上推导出:活跃人口、道路网络和社会经济互动三大要素的空间分布满足如下关系:
活跃人口密度随中心距离衰减满足幂律:
- [math]\displaystyle{ \rho(r,t) \propto r^{-\beta} }[/math]
进一步积分得到累积人口:
- [math]\displaystyle{ P(r,t) \propto r^{2-\beta} }[/math]
这里,[math]\displaystyle{ P(r,t) }[/math]是到第 [math]\displaystyle{ t }[/math] 步的时候,半径 [math]\displaystyle{ r }[/math] 内的总活跃人口数。其中 [math]\displaystyle{ \beta }[/math] 为一个与常数 [math]\displaystyle{ C }[/math] 相关的参数。我们可以利用某城市的活跃人口分布数据拟合估计出 [math]\displaystyle{ \beta }[/math] 的取值,这一取值也直接决定了其他两种要素的空间分布。
道路长度和社会经济互动在半径 [math]r[/math] 内的累积量分别满足:
- [math]\displaystyle{ L(r,t) \propto r^{2-\beta/2} }[/math]
- [math]\displaystyle{ G(r,t) \propto r^{2-3\beta/2} }[/math]
可以看到,它们的累积量都会与 [math]\displaystyle{ r }[/math] 呈现出幂律的规律,而且幂指数虽然各不相同,但是都与活跃人口的空间指数[math]\beta[/math]有关。
这些空间规模法则(Spatial Scaling)都得到了实证数据的验证,如下图:

规模法则
进一步,我们对上述累积分布规律对半径 [math]r[/math] 做积分,就可以求出一座城市中活跃人口、道路长度和社会经济互动的总量,这些总量仅与城市的半径大小有关,且呈现幂律关系:
- [math]\displaystyle{ Y\propto R^{2+\eta} }[/math]
这里的[math]Y[/math] 可以代表城市中的总人口、总道路长度,或城市中的总的社会经济互动(即GDP),[math]R[/math]为城市的半径,[math]\eta[/math]为与[math]\beta[/math]无关的幂指数。当 [math]Y[/math] 分别代表人口、道路和GDP的时候,这三个幂指数分别为:1,1/2,和3/2。由此我们可以消去 [math]R[/math],而将所有的 [math]Y[/math] 表达为人口 [math]N[/math] 的函数,可以得到如下幂律关系:
- [math]\displaystyle{ X\propto N^{\gamma} }[/math]
这里的 [math]X[/math]可以代表城市的面积、道路总长度、GDP等指标,幂律指数 [math]\gamma[/math] 会因指标的变动而变,我们可以总结为下表:
| 变量 | 理论值 | 经验值 |
|---|---|---|
| 道路长度 | 5/6 | (0.74, 0.92) |
| 国内生产总值(GDP) | 7/6 | (1.01, 1.33) |
| 面积 | 2/3 | (0.56, 1.04) |
匹配生长模型将城市增长描述为动态过程,而不是静态几何假设。这意味着该模型不仅能展现人口和道路的空间分布,还能在尺度上预测夜间灯光亮度等社会经济活动指标。这使得匹配生长模型成为理解城市复杂性和标度起源的重要理论工具。
其他
Ribeiro 与 Rybski (2021) 对城市规模法则的数学模型进行了系统综述,总结了不同理论框架下的建模方法。他们指出,虽然经验研究普遍揭示了城市变量的规模法则(如社会经济指标的超线性 [math]\displaystyle{\beta \approx 1.15}[/math],基础设施的亚线性 [math]\displaystyle{\beta \approx 0.85}[/math][36]),但其背后的机制存在多种解释。因为城市规模法则并非来源于单一机制,而是多种机制的综合结果。
这些模型大致可以分为两类:
- 城市内部模型(Intra-city models):强调城市内部人口互动和几何结构。例如,Bettencourt 模型把人类互动视为几何交叉截面,推导出城市面积与人口的 [math]\displaystyle{2/3}[/math] 次幂关系以及 GDP 的 [math]\displaystyle{7/6}[/math] 超线性关系;重力模型则假设个体间的互动概率随距离衰减,结合城市的分形空间结构,导出超线性幂律指数 [math]\displaystyle{\beta = 2 - \gamma / D_p}[/math]。
- 城市间模型(Inter-city models):强调城市之间的扩散与层级结构,例如基于 Zipf 定律的层级扩散模型,将创新传播和城市规模分布联系起来[36]。
这篇综述指出,这些不同模型虽然起点各异,但许多都可以归入统一的数学框架。例如,基于人类互动的模型往往可以形式化为:[math]\displaystyle{ Y = N \cdot g \cdot \langle k \rangle }[/math]。其中 [math]\displaystyle{g}[/math] 为单次互动产生的平均产出,[math]\displaystyle{\langle k \rangle}[/math] 为人均互动数,决定了幂律指数的大小。若互动范围扩展或社交网络具有层级性,则会出现超线性规模法则。
其他规模法则
除了上述以生命、城市和企业为代表的复杂系统之外,规模法则在各类复杂系统中是非常普遍地存在着的。以下我们再给出几个不同领域的规模法则的例子,包括生态系统、国家、在线社区等。
生态系统
在生态学中,生态系统可被视为由能量流驱动的开放热力学系统,各物种既是能量的接收者,也是能量传递与耗散的节点。正如 Chave 与 Levin 所指出[37],从个体到种群、群落再到整个生物圈,生态系统作为复杂适应系统,会在宏观尺度上呈现出可由幂律或比例关系刻画的“规模法则”,这些规律源于多尺度生态过程的耦合与统计简化。总体而言,生态系统的规模法则主要体现在三个方面:一是空间上的生物多样性变化,如物种–面积关系揭示物种数随调查面积呈幂律增长;二是空间尺度上的时间稳定性变化,如稳定性–面积关系显示生态系统在更大空间尺度上通常更稳定;三是能量流网络中的异速律与耗散律,它们从能量摄取、分配与损耗的机制层面解释了生态结构与功能随尺度的普适模式。三个方向分别对应生态系统的空间结构、时间动态与能量收支,共同构成理解生态系统多尺度组织与功能的核心框架。
空间生物多样性与稳定性
物种与面积关系
Chave 和 Levin 在其综述中指出[37]:,在相当宽的空间范围内,某区域内的物种数 [math]\displaystyle S[/math] 与调查面积 [math]\displaystyle A[/math] 之间遵循近似幂律:
- [math]\displaystyle{ S(A) \propto A^{z} }[/math]
其中 [math]\displaystyle z[/math] 是物种–面积指数,反映生物多样性随空间规模增加的速度。Chave 与 Levin 综合了岛屿、森林乃至全球尺度的植物区系数据,指出 [math]\displaystyle z[/math] 通常介于0.1到0.4之间,在全球维管植物(vascular plant species)的数据上可得到约 [math]\displaystyle z \approx 0.23[/math] 的拟合值,表明在对数–对数坐标中物种数与面积近似呈线性关系。这是多样性-规模亚线性规模法则在生态系统中的一种体现。
生态稳定性与面积关系
除了物种数,生态系统的时间稳定性也表现出随空间尺度而变化的幂律特征。Liang 等利用全球多种群长期监测数据[38],分析了“区域面积 [math]\displaystyle A[/math] 增大时,生态系统稳定性如何变化”的问题,提出了生态系统稳定性-面积关系(EStAR)框架,该框架揭示了生态系统稳定性如何随空间尺度变化。 研究发现,生态系统稳定性(以时间稳定性 [math]\displaystyle \text{TS}[/math] 衡量,定义为平均值与标准差的比值)与空间尺度 [math]\displaystyle A[/math] 之间存在幂律关系:
- [math]\displaystyle{ TS(A) \propto A^{\lambda} }[/math]
其中 [math]\lambda[/math] 为稳定性尺度指数。该研究通过分析全球范围内的多个数据集,发现:
- 空间尺度增加通常会提高生态系统稳定性( [math]\displaystyle \lambda>0[/math] ) - 稳定性尺度指数 [math]\displaystyle \lambda[/math] 可以分解为生物多样性尺度关系和多样性-稳定性关系的贡献 - 这一框架统一了群落生态学中关于生物多样性、空间尺度和生态系统功能的多个经典理论 这个研究强调了在不同空间尺度上研究生态系统过程的重要性,并为预测生境丧失对生态系统功能的影响提供了定量工具。
代谢理论与能量收支的生态系统

Kooijman 的能量预算模型则从更细致的生理学角度给出了这些幂律的机理解释[39]。他假定个体有两个重要变量:一个是状态变量大小 [math]\displaystyle W[/math] (the state variables size),另一个是能量储备 [math]\displaystyle S[/math] (storage),生物体会在摄食、同化、维护、成长、繁殖等环节之间分配不同的能量。即便该模型假设了“常规维护代谢与状态变量大小成正比”,综合不同能流分配后,模型仍旧推导出呼吸速率在种内、种间都接近于 [math]\displaystyle W^{2/3}[/math] 缩放,并能同时解释多种生理、生态指标随体型的异速关系或规模法则。
在同种内不同体型个体中: - 最大摄食率与 [math]\displaystyle W^{2/3}[/math] 成正比 - 呼吸率可表示为 [math]\displaystyle W^{2/3}[/math] 和 [math]\displaystyle W[/math] 的加权和,在对数-对数图上呈现接近线性,斜率介于 2/3 和 1 之间 - 最大繁殖率随体型的增加而降低,其尺度参数约为 -1/4
在不同物种间: - 最大摄食率随最大体型 [math]\displaystyle W_m[/math] 线性增长(尺度指数为 1) - 种群增长率随 [math]\displaystyle W_m[/math] 的增加而降低,尺度指数约为 -1/3 - 孵化时间随卵体积的 1/4 次方增长(即随 [math]\displaystyle W_m^{1/3}[/math] 增长) - 卵的失水量随 [math]\displaystyle W_m^{4/3}[/math] 增长 该模型通过 贝塔朗菲生长方程整合了能量摄入、储存、利用和耗散,为理解生物体大小与生理过程之间的规模关系提供了机制性解释。
生态流网络中的异速律
食物链网或者更加广义的能量流网络作为一种重要的生态网络,也存在着普遍的规模法则[40]。在这个网络中,节点往往代表物种或者更广义的有机物节点,连边代表物种的捕食与被捕食关系,或者更广义的节点之间的相互作用关系,连边权重则代表了物质或能量的流量,并且流量往往具备平衡的性质。因此,这类生态流网络可以被看作是一种开放流网络。
生态流网络上的规模法则往往体现为某节点上定义的指标与节点上总流量的幂律关系。例如:
异速律
在生态流网络中,所谓的异速律(Allometric Scaling)是指:某个节点对整个网络的直接与间接影响的总和[math]C_i[/math]与每个节点的总能量通量 (throughflow) [math]A_i[/math] 之间存在的幂律关系[41]:
- [math]\displaystyle{ C_i \propto A_i^{\eta} }[/math]
其中 [math]\eta[/math] 为异速指数 (allometric exponent)。在文章[41]中,作者对19个实证生态系统(包括海湾、河口、湿地等)的能量流网络中发现,这种异速关系普遍存在,指数 [math]\eta[/math] 介于 [math]0.83[/math] 至 [math]1.05[/math] 之间,大多数略高于 [math]1[/math]。这表明生态系统中的能量流分布遵循稳定的幂律模式,体现系统整体的结构组织性。其拟合优度 [math]R^2[/math] 普遍高于 [math]0.9[/math]。
[math]\eta[/math]也可以被解释为网络中心化程度的指标。
- 当 [math]\eta>1[/math]时,能量流集中于少数高通量节点,系统更具中心性;
- 当 [math]\eta<1[/math] 时,能量分布更均匀,系统趋于去中心化。
耗散律
除异速律外,研究还发现物种的能量耗散 (主要为呼吸作用) [math]D_i[/math] 与其通量 [math]A_i[/math] 之间也呈幂律关系[40]:
- [math]\displaystyle{ D_i \propto A_i^{\gamma} }[/math]
其中 [math]\gamma[/math] 为耗散指数 (dissipation exponent)。对于大多数网络, [math]\gamma<1[/math],即能量耗散随通量的增加而亚线性规模法则。这意味着能量通量越大的物种,其相对能量损失比例(定义为[math]D_i/A_i[/math]越低,因此能量利用效率更高。
异速指数[math]\eta[/math] 与耗散指数[math]\gamma[/math]的关系
此外文献[42]研究还发现了[math]\eta[/math] 与 [math]\gamma[/math] 之间存在着负相关关系:当 [math]\gamma[/math] 增大(能量损失加剧)时, [math]\eta[/math] 减小。这表明,当大流量节点的能量耗散相对更高时,网络的能量流分布更趋向去中心化;反之,当[math]\gamma<1[/math] 时,则高流量的耗散率更低,而网络更加中心化,因此能量更集中于高流量节点。
作者进一步通过流量调整算法 (在保持网络拓扑不变的情况下调节 [math]\gamma[/math])验证了这一负相关关系在流网络模型上的普遍性,结果显示 [math]\eta[/math] 随 [math]\gamma[/math] 系统性下降,这一趋势在实证网络与随机生成网络中均一致。
在能量耗散较大的系统中( [math]\gamma>1[/math] ),能量损失增加削弱了高流量节点的影响,使网络的流量更分散;当 [math]\gamma<1[/math] 时,大节点输出更多能量、影响力增强,系统的流量分布则更集中。
国家的规模法则
社会经济复杂系统中普遍地存在着规模法则,除了上面已有阐述的城市与企业,规模法则还适用于一种更大的社会经济复杂系统,这就是国家。
2010年,张江等人利用 Mathematica CountryData 数据库,对273个国家或地区的104个变量展开了系统性的规模法则研究[43],将规模法则(也被叫做异速生长律Allometric Scaling)拓展到了国家上。也可参考:异速生长律词条。
广延量与强度量
首先,该研究将所有变量划分成了两类:
- 广延型的变量;
- 强度型变量。
在物理中,所谓的广延型变量是诸如能量、质量、熵等具有子系统可加性的变量。在国家中,一些宏观总量,如人口、GDP、面积、出口、进口等都属于广延型变量。而平均的人均GDP,人口的生育率、死亡率等类似于物理中的温度、压强被称为强度量。
对于广延性的变量,张江分别研究了它们和三种不同的国家尺度变量(分别是地理尺度,即国土面积、人口尺度,即总人口和经济尺度即GDP)做规模法则分析,即用数据检验它们与不同国家尺度变量[math]X[/math](面积、人口和GDP)的幂律关系:
- [math]\displaystyle{ Y=cX^a }[/math]
这里,[math]Y[/math]为任意的宏观变量,[math]a[/math]为幂律指数,[math]c[/math]为规模法则的系数。
下面,我们选择一些典型的X与Y,陈述一些典型的结论。
人口与GDP
首先,我们可以选择[math]X[/math]代表人口作为国家规模的度量,选择国家的GDP作为[math]Y[/math]来看GDP对人口的规模法则,并可以与城市的GDP-人口的规模法则进行对比。
[43]中的结果显示,国家与城市相比,呈现出明显不同的规律。以人口和GDP的规模法则为例,虽然两者之间仍符合幂律形式,但城市的幂指数是大于1的(1.15),呈现出超线性的规模法则,而国家的幂指数 [math]a[/math] 则是小于或约等于1的,即呈现为亚线性或线性的规模法则。这说明国家相比较城市在经济产出方面不但不存在规模效应递增,而且还会出现规模效应递减的现象,即国家越大人均GDP越低。
之所以会出现这种情况,有多方面因素。首先:拟合方法的选择不合理。通常,为了拟合数据,我们大多都采用最小二乘法(Ordinary Linear Square,简称OLS)在双对数坐标下进行线性回归,这种方法会把X看作自变量,而Y看作因变量,因此暗含了X与Y有因果关系。然而,如果实际的变量X和Y不存在因果关系,而仅仅是相关关系的时候,就有可能导致幂指数的估计产生大的偏差。另一种拟合方式则是采用主轴法(Major Axis,简称MA),这种方法并不区分自变量和因变量,因而能够相对平等地对待X与Y。在国家尺度的GDP与人口的双对数坐标下的回归分析中,如果采取OLS方法,则幂指数为0.79,但如果采取MA方法,则幂指数为1.04接近于1。我们认为后者更加可信,这是因为国家的GDP与人口并不呈现明显的因果关系,而且这一结论也与后续的不同变量分析一致。
其次,变量的选择会显著影响GDP和人口这两个变量的关系。如前所述,OLS方法的基础是假设了X是自变量,Y是因变量,也就是说要存在X到Y的因果关系,这种方法才合理。然而,国家层面上看,人口和GDP的因果关系并不显著。除了采用不同的回归方式得到结论以外,我们还可以通过选择更精炼的变量来进行回归。例如,对于人口来说,我们可以选择劳动人口,甚至就业的劳动人口。显然,后两种变量的选择会与社会总产出,即GDP具有更显著的因果关系。同样地,GDP变量也可以被替换为购买力评价GDP,从而消除物价以及汇率对GDP的影响。在进行变量的替代以后,我们会看到X与Y的因果关系就会变得越来越显著,从而得到的幂指数也会越来越准。

当用劳动力人口替代总人口,并以购买力平价修正GDP时,拟合的显著性提高([math]R^2[/math] 从0.59上升至0.88),而幂指数依旧接近1,进一步验证了GDP与人口的规模法则近似线性这一结论。这说明,在国家层面,由于人与人之间的互动并不能产生规模递增效应,从而导致人均GDP不会像城市那样随着人口规模的上升而上升。
以GDP为基准的规模法则
正是因为国家与城市存在着显著的不同,人与人之间的互动并不明显,这使得人口总规模并不能作为一个良好的规模指标,特别是衡量国家的经济发展水平的时候,选取总人口作为规模指标并不合理。于是,文章探讨了另一种规模指标,即国家的GDP。当我们将GDP作为国家经济总规模的衡量的时候,各种广延量的经济指标,包括出口总额、进口总额、投资总额等等,都呈现了非常显著的与GDP的规模法则。因此,在更大的国家尺度范围中,GDP被发现比人口更能有效衡量国家尺度。
下表列出了与GDP程序明显幂律关系的各个经济广延量指标。
| 属性 | MA方法估计的幂指数 | R² | OLS方法估计的幂指数 | 样本数 |
|---|---|---|---|---|
| 购买力平价GDP(GDPAtParity) | 1.02 ± 0.03 | 0.96 | 0.99 | 230 |
| 政府债务(GovernmentDebt) | 1.10 ± 0.09 | 0.85 | 1.00 | 120 |
| 政府支出(GovernmentExpenditures) | 1.02 ± 0.04 | 0.93 | 0.98 | 224 |
| 政府收入(GovernmentReceipts) | 1.04 ± 0.04 | 0.93 | 1.00 | 225 |
| 政府盈余(GovernmentSurplus) | 1.06 ± 0.07 | 0.78 | 0.93 | 217 |
| 劳动力(LaborForce) | 1.02 ± 0.04 | 0.70 | 0.85 | 223 |
| 国民收入(NationalIncome) | 0.99 ± 0.01 | 1.00 | 0.99 | 208 |
| 农业附加值(AgriculturalValueAdded) | 0.96 ± 0.08 | 0.73 | 0.83 | 207 |
| 建筑业附加值(ConstructionValueAdded) | 0.99 ± 0.03 | 0.96 | 0.97 | 208 |
| 固定投资(FixedInvestment) | 0.98 ± 0.02 | 0.97 | 0.97 | 207 |
| 政府消费(GovernmentConsumption) | 1.00 ± 0.04 | 0.91 | 0.96 | 207 |
| 居民消费(HouseholdConsumption) | 0.98 ± 0.02 | 0.98 | 0.97 | 206 |
| 工业附加值(IndustrialValueAdded) | 1.18 ± 0.03 | 0.96 | 1.15 | 208 |
| 存货变动(InventoryChange) | 1.26 ± 0.13 | 0.67 | 0.99 | 193 |
| 制造业附加值(ManufacturingValueAdded) | 1.22 ± 0.03 | 0.95 | 1.19 | 208 |
| 其他行业附加值(MiscellaneousValueAdded) | 1.22 ± 0.03 | 0.96 | 1.03 | 208 |
| 总消费(TotalConsumption) | 0.97 ± 0.02 | 0.98 | 0.96 | 207 |
| 贸易附加值(TradeValueAdded) | 1.00 ± 0.02 | 0.97 | 0.98 | 207 |
| 交通运输附加值(TransportationValueAdded) | 1.02 ± 0.03 | 0.97 | 0.97 | 207 |
| 出口额(ExportValue) | 1.09 ± 0.05 | 0.90 | 1.03 | 208 |
| 进口额(ImportValue) | 0.95 ± 0.04 | 0.92 | 0.92 | 209 |
| 经常项目差额(CurrentAccountBalance) | 0.97 ± 0.07 | 0.84 | 0.89 | 163 |
| 外汇储备(ForeignExchangeReserves) | 1.12 ± 0.08 | 0.80 | 0.89 | 155 |
| 外债(ExternalDebt) | 1.17 ± 0.07 | 0.86 | 1.07 | 201 |
| 用电量(ElectricityConsumption) | 1.25 ± 0.09 | 0.80 | 1.09 | 215 |
| 发电量(ElectricityProduction) | 1.26 ± 0.07 | 0.85 | 1.05 | 213 |
| 石油消费(OilConsumption) | 0.95 ± 0.05 | 0.89 | 0.90 | 211 |
| 石油进口(OilImports) | 0.92 ± 0.07 | 0.77 | 0.81 | 200 |
| 碳排放(CarbonEmission) | 1.10 ± 0.06 | 0.89 | 1.03 | 153 |
| 固定电话线路(PhoneLines) | 0.98 ± 0.05 | 0.88 | 0.92 | 229 |
| 移动电话用户(CellularPhones) | 1.14 ± 0.07 | 0.83 | 1.03 | 223 |
| 广播电台数(RadioStations)* | 0.66 ± 0.06 | 0.69 | 0.58 | 205 |
| 电视台数(TelevisionStations)* | 0.75 ± 0.08 | 0.65 | 0.64 | 197 |
| 互联网用户(InternetUsers) | 1.06 ± 0.06 | 0.85 | 0.97 | 221 |
| 公路长度(RoadLength) | 0.95 ± 0.09 | 0.69 | 0.80 | 223 |
从该表中,我们不难看出,从石油、电力消耗到进出口总额,再到交通通信基础设施(如公路总长度、电话线数量、互联网用户数),几乎所有这些宏观变量都与GDP呈现高度显著的幂律关系([math]R^2>0.6[/math])[43]。
在该表中,有些指标的幂指数明显大于1,包括政府债务、工业附加值、制造业附加值、存货变动、碳排放、移动电话用户数、互联网用户数、外汇储备、出口总额等等,这些都呈现了超线性规模法则,这说明随着GDP的增长,这些指标的增长会更快;有些指标明显小于1,包括总消费、进口额、石油消费、公路长度等,这呈现了亚线性规模法则,说明它们会比GDP更慢地增长。还有一些则非常接近于1,包括购买力评价GDP、政府收入、政府支出、劳动力、国民收入等等,它们与GDP同速增长。
其中,比较有趣的事,进口额与GDP的规模法则。它们的关系可类比为国家经济系统的“代谢过程”,类似生物代谢中的克莱伯定律;而碳排放则表现出与GDP的超线性关系(幂指数为1.2),这意味着随着经济增长,碳排放会加速增加,反映出一种难以通过个体行为逆转的系统性规律。由此可以看出,国家层面的规模法则不仅在形式上区别于城市(缺乏超线性的规模经济效应),更在规律上展现出与GDP紧密相关的系统性特征。
强度量对人均GDP的依赖
此外,对强度量的分析揭示了社会发展与人类代谢之间的深层联系。随着人均GDP的提高,国家的总和生育率呈幂律下降,而平均寿命则随之上升。这种规律与生物体代谢的限制机制一致,暗示人类社会在宏观尺度上仍受到代谢生态学的约束。
该文章也研究了各种强度变量相对于人均GDP的幂律关系。虽然人均GDP不能看作是国家的规模度量,但是它却可以看作是国家社会经济体系的一种强度量的标尺,因而,不同的变量便呈现了与人均GDP的幂律关系,如下表所列:
| 变量(Property) | MA回归幂指数 | R² | OLS回归幂指数 | 样本数 |
|---|---|---|---|---|
| 识字率比例(LiteracyFraction) | 0.11 ± 0.02 | 0.40 | 0.11 | 204 |
| 出生率比例(BirthRateFraction) | -0.24 ± 0.03 | 0.58 | −0.23 | 208 |
| 预期寿命(LifeExpectancy) | 0.08 ± 0.01 | 0.48 | 0.08 | 207 |
| 中位年龄(MedianAge) | 0.14 ± 0.02 | 0.63 | 0.14 | 208 |
| 总和生育率(TotalFertilityRate) | −0.21 ± 0.03 | 0.49 | −0.20 | 208 |
| 婴儿死亡率比例(InfantMortalityFraction) | −0.58 ± 0.05 | 0.71 | −0.53 | 206 |
可以看到,这些变量的幂指数可以被分成两类,识字率、预期寿命与中位数年龄的幂指数为正,这说明随着国家变得更加富有(人均GDP提高),则人们受教育水平会提升,而预期寿命会增长;另一类包括出生率、总和生育率、婴儿死亡率等,它们的幂指数为负数,说明人均GDP提高的时候,新生儿的出生率降低,死亡率升高。这在某种程度上反映了作为一个独立个体(以经济生活为主要目的)的人,和作为一种生物学的个体(以生命的繁衍为目的)二者之间存在着一定的竞争关系。当人们的生活水平逐渐提高,人们会选择更多地提升自己的个体社会人的生活质量,而非提高作为生物人的个体繁衍率。
复杂网络
在复杂系统研究中,复杂网络(complex network)或图(graph)是一种重要的抽象形式,用于刻画社会、技术、信息系统中的交互关系。Leskovec、Kleinberg 与 Faloutsos(2005, 2007)等人通过对多种真实网络演化的序列进行分析,发现复杂网络在演化过程中遵循两条普遍的规模法则:致密化定律(densification law)与收缩直径定律(shrinking diameter law)[44] [45]。这些规律揭示了网络在增长过程中所体现出的自组织特征与临界动力学机制。
致密化幂律(densification law)
所谓的致密化就是指一个复杂网络在生长的过程中,连边数的增长速度会比节点数的增长速度更快,而且通常可以被表达为一个连边数与节点数的超线性规模法则的形式。
传统随机图模型假设网络的平均度保持常数,即边数随节点数线性增长。然而研究表明,大多数真实网络会随时间逐渐变得更加致密,节点之间的连接数以超线性方式增长[44]。具体而言,网络的边数 [math]\displaystyle E(t)[/math] 与节点数 [math]\displaystyle N(t)[/math] 之间满足幂律关系:
[math]\displaystyle E(t) \propto N(t)^{a}, \quad 1<a<2.[/math]
其中 [math]\displaystyle a[/math] 称为致密化指数(densification exponent)。当 [math]\displaystyle a=1[/math] 时,平均度保持不变;当 [math]\displaystyle a=2[/math] 时,网络接近完全图。大量实证结果显示 [math]\displaystyle a[/math] 稳定地处于 1 与 2 之间,表明平均度随时间单调上升。在 Leskovec 等人的研究中,调研的网络涵盖了多种异质系统,包括论文引用网络(arXiv HEP–TH, HEP–PH)、美国专利引用网络(Patents)、互联网自治系统(AS)、作者–论文隶属网络(Affiliation Graphs)及电子邮件通信网络等。

收缩直径定律(Shrinking Diameter Law)
另一个相伴而生的现象是,网络的有效直径(effective diameter)并非随着规模扩张而增长,而是随时间减小[44]。有效直径定义为网络中 90% 可达节点对之间的最短路径长度 [math]\displaystyle D_{\text{eff}}[/math]: [math]\displaystyle D_{\text{eff}} = \min{d: g(d) \ge 0.9}[/math],其中 [math]\displaystyle g(d)[/math] 表示距离不超过 [math]\displaystyle d[/math] 的节点对比例。
在所有实测网络(包括 arXiv、专利引用网络Patents、互联网自主系统AS 等)中,随着时间推移, [math]D_{\text{eff}}(t)[/math] 呈现单调下降或先降后稳的趋势。例如在 HEP–TH 引用网络中,平均最短路径从约 8 减至 5,而在互联网中,从 4.2 降至 3.8。这一规律表明,随着网络增长,信息或影响在系统中传播的路径反而更短,网络呈现出“超小世界”特性。

生成机制:社区引导与森林火灾模型
为解释上述规模法则现象,研究者提出了两类生成模型。
社区引导附着模型
第一个模型为社区引导的附着模型(Community Guided Attachment, CGA)。假设网络节点嵌套于层级化的社区结构中,跨社区形成连接的概率随层级深度 [math]\displaystyle d[/math] 而指数性衰减。若跨层连接概率为 [math]\displaystyle p(l) \propto c^{-l}[/math],则可推出网络的边数与节点数满足[45]:
- [math]\displaystyle{ E(t) \propto N(t)^{a} }[/math]
其中,[math]\quad a = 1+\frac{1}{(1+\alpha)d}[/math],这里 [math] \alpha[/math] 为社区紧密度参数。当 [math]\alpha[/math] 较小时,跨社区连接容易形成,系统趋向超线性致密化;当 [math]\alpha[/math] 较大时,网络增长趋近线性。
森林火灾模型
为同时解释致密化规模法则与收缩直径现象,Leskovec 等人提出了复杂网络版本的森林火灾模型(Forest Fire Model)。新节点以概率 [math]p_f[/math](前向燃烧)与 [math]p_b[/math](反向燃烧)递归连接到已有节点及其邻居:新节点选择一个“点火节点”;按概率 [math]p_f[/math] 连接其出邻居,按 [math]p_b[/math] 连接其入邻居;对新连接的节点重复此过程,直到燃烧终止。
模型模拟表明,在特定参数区域,网络自发满足[45]:[math]E(t)\propto N(t)^{a}[/math],其中,[math]1<a<2[/math],且[math]D_{\text{eff}}(t)[/math]会随着[math]N(t)[/math]的增长而下降。即该模型同时复现了超线性致密化与直径收缩。这一过程存在着相变现象:当 [math] p_f[/math] 过小,则网络连边稀疏;而如果其过大,则连接会迅速饱和;因此,仅在[math]p_f[/math]的临界区域产生现实网络的拓扑特征。
在线社区的规模法则
网络在线社区,包括网络论坛、贴吧、社交网站等是人们网络活动的主要载体之一。在在线社区中,人们通过写文章、分享、互相发表评论等行为形成了人与人(用户与用户)之间的互动。因此,网络在线社区可以看作是人类现实社区的虚拟世界投影,因此真实社区(城市)的一些规律,例如规模法则也适用于在线社区。
用户活动的超线性规模法则
2011年,吴令飞、张江在物理学评论E上发表文章[46],揭示出一类网络在线社区的规模法则效应,特别指出了用户活动(包括发帖、发图、加Tag等)的超线性规模法则,即不同时刻的用户活动总量会随着社群中活跃用户数的增加而呈现超线性规模法则,即用户活动会比活跃用户增长得更快。

如图,可以看出用户的活动总量(T,包括每一小时内的评论总量、加Tag的次数、分享总数等)与活跃用户数(P,即这个小时内的总的活动用户数量)二者之间服从如下规模法则:
- [math]\displaystyle{ T\propto P^{\gamma} }[/math]
其中[math]\gamma[/math]为幂律指数。对于这四个社区,[math]\gamma[/math]普遍大于1,但具体的数值不等。这说明,这些社区的用户活动普遍存在着超线性的规模法则。
这首先说明,用户活动会比用户规模增长得快,而且,幂指数越大,则活动数相对于用户数的增长速度越快。进一步,根据该等式,我们有:
- [math]\displaystyle{ T/P\propto P^{\gamma-1} }[/math]
由于[math]\gamma>1[/math],所以[math]\gamma-1>0[/math],所以,该式表明:平均每用户的活动数会随着规模的增长而增长,也就是说社区变得越大,平均每个用户的活动会更多,即社区的变大刺激了用户变得更加活跃。
这种规模效应的产生源于用户之间的非线性相互作用。试想,假如用户来到社区后没有任何的交互,彼此独立地访问,则可以预期每个用户的平均访问活动次数是一个独立的随机数,该随机数有着固定的均值和方差。那么,在统计了大量用户以后,根据大数定律,这个平均访问长度就是一个与规模无关的常数,也就是说[math]T[/math]与[math]P[/math]呈现线性关系;而如果用户彼此之间有相互作用,A用户的访问行为会影响B,反之亦然。那么,随着用户越来越多,它们彼此的交互行为也就越来越多,这就体现为平均浏览长度随着规模的增长而增长的效应。这种非线性效应就可以用幂指数[math]\gamma[/math]来体现。
进一步,两位作者将这一实证观察与另一种实证观察联系了起来,即每个小时内网络社区中不同用户所产生的活动是一个随机变量,该随机变量的分布曲线具有一种尺度依赖效应,也就是说该分布曲线会随着整个社区的增长(即用户量的增长)而增大,这一增大趋势与规模法则密切相关。该文章从数学上证明了,满足一定关系的尺度依赖分布能够推导出规模法则。
第5.2.2节介绍的匹配生长模型可以为网络在线社区的超线性增长提供一定程度上的解释。其中,网络的节点对应社区里面的活跃用户;网络的连边则对应为用户彼此之间的相互作用,这些相互作用则进一步以一定概率转化为活动;网络的生长空间则对应为用户的抽象特征空间。
百度贴吧的规模法则
2014年,两位作者进一步将这一规模法则推广到更广泛的网络论坛的研究之中[47]。他们研究的对象是将近30万个百度贴吧,每个贴吧都有一个相对固定的话题,并且贴吧的建立与凋零基本全部是自组织形成的。作者们将百度贴吧论坛视为“虚拟生命体”,提出在线社区的增长与用户行为遵循类似生物代谢的幂律规律。以百度贴吧三万个论坛为样本,研究发现在t时刻,某一贴吧的页面浏览量[math]PV_t[/math]与它的独立访客数 [math]UV_t[/math] 之间存在稳定关系:
- [math]\displaystyle{ PV_t = aUV_t^{\theta} }[/math]
其中[math]\theta[/math] 为幂律指数(allometric exponent)。我们显然可以将[math]PV_t[/math]看作是活动数[math]T[/math],而独立访客数看作是活跃用户数[math]P[/math],因此这一规模法则是上述网络社区的活动的超线性规模法则的延展。然而,与前一研究不同的是,在30万个网络贴吧中,存在着幂指数小于1的情况。当 [math]\theta>1[/math] 时,论坛增长呈超线性特征,访问量会比独立访客数更快地增长;若 [math]\theta<1[/math],则为亚线性增长,访问页面数的增长慢于访客数的增长。
然而,之所以可以将百度贴吧的这一规模法则视作是虚拟网络论坛的“广义克莱伯定律”是因为我们还可以从注意力流网络的视角来看待这一规律。
流网络的视角
为了理解为什么百度贴吧的规模法则可以理解为一种广义的克莱伯定律,让我们首先从注意力流网络的视角来看待每个贴吧。首先,我们可以根据每一个小时内,用户对某一个贴吧的访问日志来构建注意力流网络,如下图所示:

在该图中,左边的一串字母和数字就对应了一个模拟的用户访问日志。其中a,b,c对应为三个不同的假想的用户,0,1,2,3则对应了不同的假想的帖子,每一行构成了一条访问记录,而且这些记录通常是按照时间顺序从前到后排列的。根据该图,用户访问记录显示:a用户先访问了0号帖子,再访问1号帖子,再访问2号帖子,然后下网(因为在该记录中a不再出现);紧接着,是b用户先访问了0,再访问2,……。根据这些访问记录,我们可以构建一个注意力流网络,如右图所示。
该网络中的节点为访问过的帖子,连边则代表了日志中存在过的用户的接续访问,连边上的权重则为从某节点到另一个节点接续访问的流量。例如,在这个示意图的注意力流网络中,所有同一个用户访问过的接续的帖子,都会对应到右侧的网络中的一条连边,且改例中流量为1。其次,我们人为地添加了两个节点,即源和汇。每当一个新的用户出现在访问记录中,就会记录一条从源到该用户访问的第一个帖子的1单位流量(如果这条连边商不存在,则添加一条连边,且设置权重为1);而每当用户不再出现在访问日志中,则添加用户最后一个访问节点到汇的1单位流量(如果这条连边商不存在,则添加一条连边,且设置权重为1)。因此,如果我们以一个小时作为一个统计时间长度,那么,每一小时内的访问数据就可以构建一个注意力流网络,并且该流网络必然满足流量平衡条件。
其次,对于任意一个注意力流网络,我们可以计算两个宏观统计量:一个是总的入流,另一个则是该网络的所有连边上的总流量。那么,不难发现,按照我们的建网方式,总的入流流量就刚好是独立访客数,即[math]UV_t[/math];而总流量则刚好是用户浏览总量,即[math]PV_t[/math]。根据Banavar流网络模型(参见本词条5.3.1节),总入流即可理解为生命体的新陈代谢率,而全网络的总流量则可以看作是生命体的体重。
因此幂律关系式:[math]PV_t\propto UV_t^{\theta}[/math]实际上反映的是将每一个贴吧视作虚拟生命体之后,该生命体广义的体重(即总流量)和广义的新陈代谢率(即总入流)之间的幂律关系,即广义的克莱伯定律。而[math]1/\theta[/math]为类似3/4的幂指数。
粘性指标
作者进一步认为,如果将每一个用户的浏览行为看作是一个“粒子”在社区注意力流网络中的流动行为,那么平均每个独立访客所访问的页面数,就会刚好等于平均每个粒子在网络中的流转路径长度,记为[mat]L_t[/math],它可以定义为:
- [math]\displaystyle{ L_t\equiv\frac{PV_t}{UV_t}\propto PV_t^{1-1/\theta} }[/math]
后面的等式是从广义的克莱伯定律推导出的幂律关系。由于对于一般的贴吧来说,[math]\theta>1[/math]都成立,因此平均浏览长度随着贴吧的规模(点击量或独立访客的数量)增大而增大,即贴吧越大(体现为访客数越多),则访客的平均浏览长度越长。而当[math]\theta<1[/math]的时候,平均浏览长度则随着贴吧的规模增大而减小。因此,作者认为[math]\theta[/math] 可作为某贴吧的长期稳定的“粘性指标”(Stickness)[47]。
实证结果显示,86% 的论坛符合此规律,平均 [math]\theta=1.06[/math](标准差 0.10),约 82% 的论坛为高粘性社区。
耗散律
此外,贴吧论坛的点击流耗散(the dissipation of clickstreams)满足另一幂律关系:
[math]D_i = bT_i^{\gamma}[/math]
这被称为耗散律,即流网络中每个节点的耗散流随总流量呈非线性的幂律关系,其中 [math]T_i[/math] 为第i个节点的总流量(在贴吧中,即每个帖子的点击率),[math]D_i[/math] 为耗散流量(在贴吧中,这体现为有多少用户在看过第i个帖子之后就立即离开了该贴吧);[math]\gamma[/math] 为耗散律幂指数。
如果[math]\gamma>1[/math],则表明越大流量([math]T_i[/math])的节点,其耗散率(定义为[math]\alpha=D_i/T_i[/math])就会越高,即用户会在这样的大流量节点上以较大的概率流失,且[math]\gamma[/math]越大,流失率随流量增大而增大得越快;反之,若[math]\gamma<1[/math],则节点上的用户流失率反而会随着流量的增大而减小。
研究发现,多数贴吧的[math]\gamma<1[/math],这表明大流量节点上的流失率反而比小流量节点更小。
[math]\theta[/math]与[math]\gamma[/math]的负相关
论文[47]进一步指出 [math]\displaystyle \theta[/math] 与 [math]\displaystyle \gamma[/math] 之间存在着负相关关系,并满足不等式:
当[math]0<\gamma<1[/math]时:
- [math]\displaystyle{ 1\lt \theta\lt 1/\gamma; }[/math]
当[math]\gamma>1[/math]时:
- [math]\displaystyle{ 1/\gamma\lt \theta\lt 1 }[/math]
这表明,[math]\gamma[/math] 越小、大流量节点的耗散率反而更低,因此该贴吧的粘性越高,更具吸引力(参见6.1.3)。这一发现的意义在于,真正好的(即粘性高的)贴吧、论坛或社区并不一定是热度很高、流量很大的社区,而是能够通过高关注度的帖子把用户尽可能以更大的概率留下来的那些社区。
研究还发现,“体育”“女性”等类贴吧具有高 [math] \theta[/math]、低 [math]\gamma[/math]的特性,这说明这些贴吧更具粘性;而“艺术”“动漫”等则相反。由此,[math]\theta[/math] 表征社区的长期锁定能力,[math]\gamma[/math] 则刻画其注意力耗散效率。
交互式的列维飞行模型
为了解释上述观察到的现象,特别是注意力流网络的各种特性,如耗散律以及[math]\theta[/math]与[math]\gamma[/math]的负相关性,曾凡齐、张江等人提出了交互式的列维飞行模型(interactive Lévy flight model)。研究认为,在线社区中的每位用户的兴趣可被视作分布在d维欧几里得空间中的点,用户在不同主题间的跳转可模拟为列维飞行(Lévy Flight) 随机游走过程[48]。
模型构建
- 注意力迁移
具体地,考虑一个d维的“兴趣空间”,大量的用户的注意力迁移(即浏览行为)可以被建模为这一空间中的随机游走行为。在每个时间步,每位用户的一步跳转行为的方向是d维空间中的随机方向,而一步跳转的步长为一个随机数[math]l[/math],它满足幂律分布,即:
- [math]\displaystyle{ P(l)\sim l^{-\lambda} }[/math]
其中 [math]\lambda[/math] 为一参数,描述了这些用户的平均兴趣广度。如果[math]\lambda[/math]值越小,则长距离的跳转越频繁,表示用户的兴趣转移越剧烈,他的兴趣也很容易更广泛。
- 接续跳转与流失
其次,空间中分布着一些固定的资源节点,这些节点都是由自己或其它用户随机生成的资源节点(见下一小节),代表该网络社区/贴吧/论坛中已经存在的数字资源(帖子、文件等)。当用户跳转到了一个新的空间位置X以后,如果该位置有一个资源节点,则用户可以进行下一步随机跳跃,否则用户会直接离开(体现为该随机游走粒子消失)。
- 创建新资源点
同时,在每一个时间步,用户都会以概率 [math]p[/math] 在当前的空间点(兴趣点)生成一个新的数字资源(帖子、评论等),这些资源节点一旦创建就不再消失。这里[math]p[/math]模型的另一个参数。
按照上述步骤模拟[math]N[/math]个用户的随机跳转行为,就会形成大量的随机游走用户,大量的随机跳跃由于遇不到存在的资源节点则导致用户消失(离开该社区/论坛)。而用户在跳跃中还会以一定的概率随机地创建数字资源节点。一旦数字资源节点的覆盖面积足够大,那么用户就可以持续地跳转下去,因此延长他们的跳跃次数。当所有的用户都消失了,则一次模拟结束。
注意力流网络的构建
模拟结束后,我们便可以根据所有随机游走用户的访问历史构建注意力流网络。首先,这些留下的资源节点就构成了最终注意力流网络中的“节点”。节点在d维空间中的坐标代表了不同的兴趣主题。连边代表了在两个节点之间的接续跳转行为,边的权重表示用户在不同主题间的迁移次数(流量)。
宏观变量与规模法则
为了得到规模法则,我们可以构造如下宏观变量:
- 活动总量 [math]A[/math]:即用户完成了多少次跳跃;
- 用户数[math]N[/math]:即一开始释放的随机游走用户的个数;
- 兴趣多样性 [math]D[/math]:已被创建的资源节点在d维空间中的覆盖体积(也就是注意力流网络中节点的个数);
- 转移多样性 [math]E[/math]:注意力流网络中的所有连边数。
这些宏观变量[math]A,D,E[/math]均呈现与用户数 [math]N[/math] 的规模法则:
- [math]\displaystyle{ A\propto N^{\alpha},\quad D\propto N^{\beta},\quad E\propto N^{\gamma} }[/math]
其中 [math]\alpha>1[/math] 显示活动的超线性规模法则,而 [math]\beta<1[/math] 反映内容多样性的亚线性规模法则。模拟结果与百度贴吧、Stack Exchange 等实证数据一致,证明用户间的间接互动可自发产生与现实网络在线社区/论坛/贴吧相同的规模法则。
此外,网络边数与节点数之间满足规律:
- [math]\displaystyle{ E\propto D^{\theta} }[/math]
这也是复杂网络密集化定律的体现([math]E,D[/math]分别是注意力流网络的连边数和节点数)。
生成的注意力流网络同样存在着耗散律现象,以及耗散律的幂指数与幂指数[math]\alpha[/math]存在着负相关关系。
通过调整参数 [math]\lambda[/math] 和 [math]p[/math],模型可以产生不同的幂律指数。因此,我们也可从观测数据之中的幂律指数反推这两个参数值,以反映真实用户的兴趣跨度与内容生成倾向。该模型揭示了虚拟空间中人类行为的几何起源,为理解在线社区的增长、推荐机制与注意力流的分布提供了一种理论解释。
临界态
在复杂系统研究中,临界态(critical state)指系统在有序与无序之间的过渡点处所呈现的特殊状态。在这一状态下,系统对外部扰动的响应表现出强烈的相关性和尺度不变性(scale invariance)。Christensen和Moloney在《复杂性与临界性》书中指出,许多复杂系统在演化过程中会自发地靠近临界点,而无需外部精确调节,这一现象被称为自组织临界性(self-organized criticality, SOC)。在临界态下,系统的统计特征常常遵循幂律分布,反映出其内部的协同与层级结构[49]。规模法则也常常在临界现象中。
自组织临界性与沙堆模型
例如,在临界现象的研究中,最具代表性的自组织模型是 Bak、Tang 与 Wiesenfeld (BTW) 于 1987 年提出的沙堆模型(sandpile model)。该模型展示了复杂系统如何在没有外部调节的情况下自发演化至临界状态。
模型假设在一个二维格点上不断堆积沙粒,当局部斜率超过某个阈值时,局部区域的沙粒会向周围扩散,形成所谓的“雪崩”(avalanche)事件。每次雪崩都会重新分配系统的能量,使系统从微观扰动中逐步趋向宏观平衡。经过充分演化后,系统自发达到一个临界稳态,在该状态下,所有统计量都呈现出幂律分布的标度特征[49]。
在该临界稳态下,一次雪崩的持续时间 [math]T[/math]和这次雪崩的规模大小 [math]s[/math]就服从一个规模法则 :
- [math]\displaystyle{ T \propto s^{\beta} }[/math]
其中幂指数为:[math]\beta[/math]。除此之外,雪崩大小和持续时间的概率分布也都满足幂律的形式:
- [math]\displaystyle{ P(s) \propto s^{-\tau}, \qquad P(T) \propto T^{-\alpha}. }[/math]
其中 [math]\alpha, \tau[/math] 都为幂律指数;[math]\alpha,\beta,\tau[/math]统称为临界指数(critical exponents),决定了系统在不同尺度上的统计规律。进一步的数值模拟与实验表明,这些指数的具体数值因模型维度与局部动力学而异,但其幂律形式具有普适性(universality)。这意味着,无论系统的微观细节如何,只要具备能量累积与阈值释放的机制,都会自然演化到一个幂律主导的临界态。
在有限系统中,雪崩规模的分布还满足有限尺度标度形式:
- [math]\displaystyle{ P(s,L) = s^{-\tau} f\left(\frac{s}{L^{D}}\right), }[/math]
其中 [math]L[/math] 为系统线性尺度, [math]D[/math] 为雪崩的特征维度(fractal dimension),该式也体现为一种尺度依赖的分布形态(参见6.1.3)。这一标度律表明,不同规模系统的统计行为可以通过合适的归一化函数 [math]f(x)[/math] 统一到同一曲线之上,揭示了临界系统的自相似性与无尺度性。
大语言模型
大语言模型(LLM)的性能提升与模型规模、训练数据和算力投入密切相关,研究发现它们普遍遵循可预测的规模法则(Scaling Laws),主要包括以下几个方面:
训练阶段的规律
早期研究(Kaplan 等)表明[50],测试误差(L)随参数数量(N)、数据量(D)和最优分配的计算量预算(C)的增加呈幂律下降,且单独扩展某一要素会出现减益,需三者协同扩展。即有如下规模法则:
这表明,当参数量受限,在一个充分大的数据集上得到足够的训练,则有测试误差与参数量之间的规模法则(以模型参数量为规模):
- [math]\displaystyle{ L\propto N^{-0.076} }[/math]
如果数据量受限,训练需要早停,则测试误差与数据量之间存在着规模法则(以数据量为规模):
- [math]\displaystyle{ L\propto D^{-0.095} }[/math]
当训练过程中的计算量受限,但是数据量充足,在一个最优尺度的模型和一个充分小的批处理尺寸,有如下测试误差与最优计算量之间的规模法则:
- [math]\displaystyle{ L\propto C^{-0.05} }[/math]
这些规模法则让人们看到,在一定条件下,持续地提高参数量或数据量,会让模型的性能持续地改善。因此,大模型的规模法则成了人们押注更大的模型和更充足的数据量的科学基础。
进一步,当我们训练模型让其达到一定的表现性能的时候(也就是给定测试损失误差[math]L[/math]),我们更关心不同投入(即数据量[math]D[/math],参数量[math]N[/math]与计算量[math]C[/math]))彼此之间的关系。例如,如果以模型的参数量[math]N[/math]为规模,则在达到一定性能的前提下,数据量会[math]D[/math]与参数量呈现规模法则:
- [math]\displaystyle{ D\propto N^{0.74} }[/math]
有趣的是,如果我们将大语言模型视为一个生物体,其体重规模可以用它的参数量来衡量,而喂给它的数据视作该生物体的“新陈代谢”,则上式与克莱伯定律相似(见3式)。
如果以模型的计算量为规模变量,则在保持训练损失不变的条件下,有关于参数量和数据量如下的规模法则:
- [math]\displaystyle{ N\propto C^{\alpha} }[/math]
- [math]\displaystyle{ D\propto C^{\beta} }[/math]
这里,[math]\alpha\approx 0.73, \beta\approx 0.27[/math]。这里计算量[math]C[/math]作为大模型的规模度量是合理的,这是因为在数据和模型架构得到优化后,计算量是预测最终模型性能最可靠、最根本的约束条件。
随后,Hoffmann 等提出 Chinchilla 法则:在给定算力预算下,模型规模与训练数据量应大致保持 1:1 平衡。许多大型模型(如 GPT-3、Gopher)实际上训练不足,而更小但数据更多的 Chinchilla 模型在基准上全面领先。这一原则成为近年新模型(如 LLaMA)的重要设计指导[51]。经过修整后,上述两个规模法则的幂律指数都更新为[math]\alpha\approx\beta\approx 0.5[/math]. 这揭示了在固定算力 [math]C[/math] 下模型规模 [math]N[/math] 与训练数据量 [math]D[/math] 的最优配置关系。Chinchilla 法则指出模型参数和训练语料应随算力的平方根同比增长,即保持约 1:1 的平衡,而 Kaplan 早期公式则倾向于更大模型和较少数据,但这一策略被证明会造成训练不足。总体而言,这些关系说明在算力受限时,只有模型规模与数据规模同步扩展,才能使模型达到最优性能;单独增大其中一项都会进入收益递减区间。
推理阶段的规律
训练完成后,增加推理时的计算同样带来性能增益。例如 AlphaGo 的棋力随蒙特卡洛树搜索次数的增加呈对数线性提升;AlphaCode、GPT-4 等模型在增加候选生成、采样次数或链式推理步骤时,解题成功率也持续提高。规律表明:在应用阶段扩充推理计算,可以部分替代模型规模的不足,但收益逐渐递减[51]。
分段幂律与断裂点
Caballero 等提出“断裂式规模法则”(Broken Neural Scaling Laws),发现性能曲线并非始终遵循单一幂律,而是在不同规模区间呈现分段斜率。这种“拐点”现象广泛存在于语言、视觉、多模态、强化学习等任务中,说明模型扩展的收益可能阶段性放缓或重新加速 [51]。
- [math]\displaystyle{ y = a + (bx^{-c_0}) \prod_{i=1}^{n} (1+(x/d_i)^{1/f_i})^{-c_i f_i} }[/math]
在这个公式中,[math]x[/math] 代表规模因子(如模型参数 [math]N[/math]、数据量 [math]D[/math] 或计算量 [math]C[/math]),[math]y[/math] 是性能指标(如误差或奖励),而 [math]d_i[/math] 表示性能变化的“断点”。当 [math]x[/math] 逐渐增大并接近某个 [math]d_i[/math] 时,模型的性能提升速率(幂律指数)会平滑地发生改变。这意味着性能随规模扩展的曲线并不是单一斜率的直线,而是由多个幂律阶段平滑连接而成。它反映出模型训练的不同阶段可能受到不同机制或瓶颈的主导,从而出现“快速提升—停滞—再加速”的周期性特征。参数[math]f_i[/math]控制着第[math]i[/math]个断裂点的尖锐程度(sharpness),也可以控制各个区间上的规模法则的陡峭程度,比如[math]f_i[/math]越大,这个断裂点就越光滑,[math]f_i[/math]越小,则断裂点越尖锐。
微调与迁移规律
在下游任务上,预训练模型显著改善小数据场景的表现,相当于“放大”了微调数据集。研究表明,性能随参数规模和微调数据量呈幂律关系,并可定义“等效转移数据”来衡量预训练带来的增益。这解释了为什么更大预训练模型在低资源任务上更具优势[51]。
- [math]\displaystyle{ D_{\text{effective}} \approx K N^{\alpha} D_{\text{finetune}}^{\beta} }[/math]
该公式定义了“等效转移数据量” [math]D_{\text{effective}}[/math],表示如果没有预训练,要获得同样性能需要多少下游数据。[math]K[/math]为规模法则的系数。预训练模型的参数规模 [math]N[/math] 越大,其微调时的增益越明显,即 [math]\alpha[/math] 越大时,模型泛化能力越强;而 [math]\beta[/math] 则反映目标数据与预训练数据分布的相似度。整体来看,这一关系说明更大的预训练模型相当于给任务“虚拟地”增加了更多数据,尤其在低资源场景中,预训练带来的收益最为显著。
知识记忆与容量限制
大语言模型(LLM)的事实记忆能力基本随参数线性扩展,但存在上限。研究估计,每个参数平均只能存储约 3.6 比特的信息,意味着仅靠增大数据规模无法无限增加模型记忆,最终会趋于饱和。因此,检索增强等外部机制被认为是突破参数记忆瓶颈的关键[51]。
- [math]\displaystyle{ I_{\max}\approx 3.6N\ \text{bits} }[/math]
该公式表明模型的总记忆量[math]I_{\max}[/math]与参数数量[math]N[/math]呈线性关系,且每个参数能存储的信息量几乎固定。当训练数据量超过模型能记住的总容量时,模型会自动转向泛化学习而非记忆具体事实。因此,继续增加数据并不会提升总记忆,只会降低单个样本被精确记住的概率。换言之,模型的记忆空间是有限资源,扩展记忆的唯一方式是增加参数或借助外部知识检索机制。
参数效率的提升
除了单纯“做大”,模型单位参数的有效性也在快速提高。所谓的密集化法则(Densing Law)则指出,模型的“容量密度”大约每 3 个月翻一倍,显示算法、架构和训练方法的持续改进让更小的模型也能达到过去大模型的水平,类似“摩尔定律”的趋势 [51]。
其他扩展方向
低精度训练可视为减少“有效参数”,其性能损失遵循指数规律[51]:
- [math]\displaystyle{ N_{\text{eff}}(P)=N\bigl(1-e^{-P/\gamma}\bigr) }[/math]
其中 [math]P[/math] 是数值精度的位宽,随着精度提升,有效参数量 [math]N_{\text{eff}}[/math] 按指数方式逼近真实参数数 [math]N[/math],[math]\gamma[/math]为拟合的指数。这说明低精度训练会以非线性方式损失模型容量,例如使用 FP16 精度时仅约 90% 的参数在发挥作用,而更低精度会进一步削弱性能。
此外,多模态任务(如同时处理文本与图像的模型)也遵循类似的幂律关系。以视觉模型为例,其最低错误率与计算量的关系可以近似表示为[51]:
- [math]\displaystyle{ L_{\min}(C)=0.09+\frac{0.26}{(C+0.01)^{0.35}} }[/math]
这表明随着计算量[math]\displaystyle{ C }[/math] 的增加,模型的误差率持续下降但趋于饱和,体现了典型的“收益递减”规律,也进一步印证了规模法则的普适性。
参考文献
- ↑ 武际可 (2006). 关于两门新科学的对话. 北京大学出版社.
- ↑ 2.0 2.1 2.2 2.3 2.4 2.5 West, G. B. (2018). 规模: 复杂世界的简单法则. 中信出版社.
- ↑ Small, Christopher G. (1996). The Statistical Theory of Shape. Springer. p. 4. ISBN 0-387-94729-9.
- ↑ Damuth J (February 2001). "Scaling of growth: plants and animals are not so different". Proc. Natl. Acad. Sci. U.S.A. 98 (5): 2113–4. Bibcode:2001PNAS...98.2113D. doi:10.1073/pnas.051011198. PMC 33381. PMID 11226197.
- ↑ Otto Snell (1892). "Die Abhängigkeit des Hirngewichts von dem Körpergewicht und den geistigen Fähigkeiten". Arch. Psychiatr. 23 (2): 436–446. doi:10.1007/BF01843462.
- ↑ Thompson, D'Arcy W (1992). On Growth and Form (Canto ed.). Cambridge University Press. ISBN 978-0-521-43776-9. http://books.google.com/books?id=7_F4OUJmLFcC.
- ↑ Huxley, Julian S. (1972). Problems of Relative Growth (2nd ed.). New York: Dover. ISBN 0-486-61114-0.
- ↑ 8.0 8.1 E. Buckingham (1914). "On Physically Similar Systems; Illustrations of the Use of Dimensional Equations". Physics Reviews. 4 (4): 345-376.
- ↑ P W Bridgman (1922). Dimensional Analysis. Kessinger Publishing.
- ↑ [1]
- ↑ Joseph Robert Burger; Menshian Ashaki George; Claire Leadbetter; Farhin Shaikh (2019). "The allometry of brain size in mammals". Journal of Mammalogy. 100 (2): 1-8.
- ↑ Whitfield, J. (2006). In the beat of a heart: life, energy, and the unity of nature. Washington, D.C. : Joseph Henry Press.
- ↑ Kleiber, M. (1932). Body size and metabolism. Hilgardia, 6, 315.
- ↑ West, G. B., Woodruff, W. H., & Brown, J. H. (2002). Allometric scaling of metabolic rate from molecules and mitochondria to cells and mammals. Proceedings of the National Academy of Sciences, 99(suppl_1), 2473-2478.
- ↑ 15.0 15.1 Bettencourt, L. M. (2013). The origins of scaling in cities. science, 340(6139), 1438-1441.
- ↑ 16.0 16.1 16.2 16.3 16.4 16.5 Bettencourt, L. M., Lobo, J., Helbing, D., Kühnert, C., & West, G. B. (2007). Growth, innovation, scaling, and the pace of life in cities. Proceedings of the national academy of sciences, 104(17), 7301-7306.
- ↑ Bettencourt, L. M., Lobo, J., & Strumsky, D. (2007). Invention in the city: Increasing returns to patenting as a scaling function of metropolitan size. Research policy, 36(1), 107-120.
- ↑ 18.0 18.1 18.2 18.3 18.4 18.5 18.6 18.7 18.8 张江. (2023). 规模法则:探索从细胞到城市的普适规律. 人民邮电出版社.
- ↑ Andris, C., & Bettencourt, L. M. (2014). Development, information and social connectivity in Côte d’Ivoire. Infrastructure Complexity, 1(1), 1.
- ↑ Bettencourt, L. M., Lobo, J., Strumsky, D., & West, G. B. (2010). Urban scaling and its deviations: Revealing the structure of wealth, innovation and crime across cities. 'PloS one, 5(11), e13541.
- ↑ 21.0 21.1 21.2 Zhang, J., Kempes, C. P., Hamilton, M. J., Tao, R., & West, G. B. (2021). Scaling laws and a general theory for the growth of public companies. arXiv preprint arXiv:2109.10379.
- ↑ Xu, J., Chen, X., Wen, L., & Zhang, J. (2023). Company scaling and its deviations: New indicators for enterprise evaluation and bankruptcy prediction. Plos one, 18(10), e0287105.
- ↑ 23.0 23.1 23.2 West, G. B., Brown, J. H., & Enquist, B. J. (2001). A general model for ontogenetic growth. Nature, 413(6856), 628-631.
- ↑ 24.0 24.1 Brown, J. H., Gillooly, J. F., Allen, A. P., Savage, V. M., & West, G. B. (2004). Toward a metabolic theory of ecology. Ecology, 85(7), 1771-1789.
- ↑ Even W E; Macpherson D A. (1996). "Employer size and labor turnover: The role of pensions". ILR Review. 49 (4): 707-728.
- ↑ 26.0 26.1 Geoffrey B. West; James H. Brown; Brian J. Enquist (1999). "The Fourth Dimension of Life: Fractal Geometry and Allometric Scaling of Organisms". Science. 284: 1677-1679.
- ↑ 27.0 27.1 Geoffrey B. West; James H. Brown; Brian J. Enquist (1997). "A General Model for the Origin of Allometric Scaling Laws in Biology". Science. 276: 122-126.
- ↑ 29.0 29.1 29.2 Dreyer, O. (2001). Allometric scaling and central source systems. Physical Review Letters, 87(3), 38101-1-38101–38103
- ↑ Glazier, D. S. (2014). Metabolic scaling in complex living systems. Systems, 2(4), 451–540.
- ↑ Bettencourt, L. M. A. (2013). The origins of scaling in cities. Science, 340(6139), 1438–1441. https://doi.org/10.1126/science.1235823
- ↑ 32.0 32.1 贝当古城市模型
- ↑ 33.0 33.1 33.2 Zhang, J., Li, X., Wang, X., Wang, W.-X., & Wu, L. (2015). Scaling behaviours in the growth of networked systems and their geometric origins. Scientific Reports, 5(1).
- ↑ 34.0 34.1 34.2 34.3 Li, R.; Dong, L.; Zhang, J.; Xinran Wang; Wen-Xu Wang; Zengru Di; H. Eugene Stanley (2017). "Simple spatial scaling rules behind complex cities". Nature Communications. 8 (1841).
- ↑ 匹配生长随机几何图模型
- ↑ 36.0 36.1 Ribeiro, F. L., & Rybski, D. (2021). Mathematical models to explain the origin of urban scaling laws: a synthetic review. 1–22. http://arxiv.org/abs/2111.08365
- ↑ 37.0 37.1 Chave, J.; Levin, S. (2003). "Scale and Scaling in Ecological and Economic Systems". Environ Resource Econ. 26: 527–557.
- ↑ Liang, M.; Yang, Q. (2025). "Unifying spatial scaling laws of biodiversity and ecosystem stability". Science. 387(6740).
- ↑ Kooijman, S. (1986). "Energy budgets can explain body size relations". Journal of Theoretical Biology. 121(3): 269–282.
- ↑ 40.0 40.1 Jiang Zhang; Yuanjing Feng (2014). "Common patterns of energy flow and biomass distribution on weighted food webs". Physica A. 405: 278-288.
- ↑ 41.0 41.1 Jiang Zhang; Liangpeng Guo (2010). "Scaling Behaviors of Weighted Food Webs as Energy Transportation Networks". Journal of Theoretical Biology. 264: 760-770.
- ↑ Jiang Zhang; Lingfei Wu (2013). "Allometry and Dissipation of Ecological Flow Networks". PLoS ONE. 8 (9): e72525.
- ↑ 43.0 43.1 43.2 Zhang, Jiang. "Allometric scaling of countries". Physica A. Event occurs at 2010: 4887–4896.
- ↑ 44.0 44.1 44.2 Leskovec, J., Kleinberg, J., & Faloutsos, C. (2007). Graph evolution. ACM Transactions on Knowledge Discovery from Data, 1(1), 2. https://doi.org/10.1145/1217299.1217301
- ↑ 45.0 45.1 45.2 Leskovec, J., Kleinberg, J., & Faloutsos, C. (2005). Graphs over time. Proceedings of the Eleventh ACM SIGKDD International Conference on Knowledge Discovery in Data Mining, 177–187. https://doi.org/10.1145/1081870.1081893
- ↑ Lingfei Wu; Jiang Zhang (2011). "Accelerating growth and size-dependent distribution of human online activities". Physical Review E. 84: 026113.
- ↑ 47.0 47.1 47.2 Wu, L., Zhang, J., & Zhao, M. (2014). The metabolism and growth of web forums. PLoS ONE, 9(8). https://doi.org/10.1371/journal.pone.0102646
- ↑ Zeng, F., Gong, L., Liu, J., Zhang, J., Chen, Q., & Xin, R. (2020). Human mobility in interest space and interactive random walk. Journal of Physics: Complexity, 1(2), 025004. https://doi.org/10.1088/2632-072x/ab7f4f
- ↑ 49.0 49.1 Christensen, K., & Moloney, N. R. (2006). Complexity and criticality = 复杂性和临界状态. Fudan University Press.
- ↑ Jared Kaplan; Sam McCandlish; Tom Henighan; Tom B. Brown; Benjamin Chess; Rewon Child (2020). "Scaling Laws for Neural Language Models". arxiv. arXiv:2001.08361.
- ↑ 51.0 51.1 51.2 51.3 51.4 51.5 51.6 51.7 大语言模型的规模法则