“RealNVP”的版本间的差异
小 (NIS 应用示例配图修改) |
小 (调节图片排版) |
||
| 第198行: | 第198行: | ||
| | ||
== 自然图像密度估计与生成 == | == 自然图像密度估计与生成 == | ||
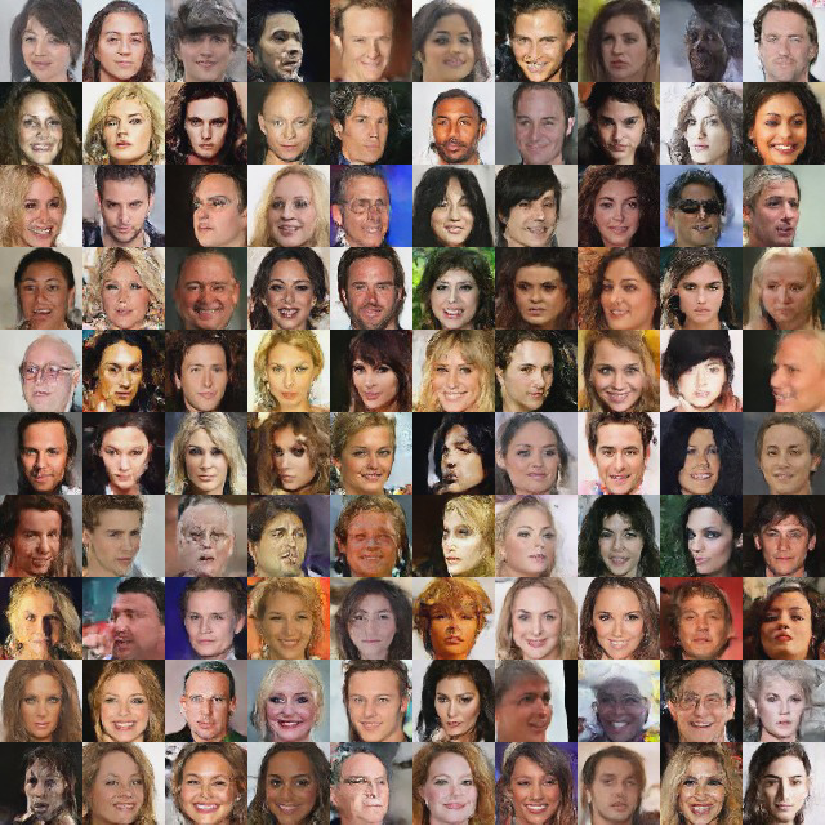
| + | [[文件:realnvp_celeba_generation.png|缩略图|RealNVP 在 CelebA 上生成的人脸样本。引自 Dinh et al., 2017。|264x264px|链接=Special:FilePath/Realnvp_celeba_generation.png]] | ||
| | ||
RealNVP 最直接的应用场景是连续高维数据的密度估计与无条件生成。在图像生成任务中,模型一次性学习整个图像的联合分布,然后直接从标准高斯分布采样并通过逆映射得到新图像。由于采样过程不依赖逐像素的顺序解码,生成速度显著高于自回归模型。 | RealNVP 最直接的应用场景是连续高维数据的密度估计与无条件生成。在图像生成任务中,模型一次性学习整个图像的联合分布,然后直接从标准高斯分布采样并通过逆映射得到新图像。由于采样过程不依赖逐像素的顺序解码,生成速度显著高于自回归模型。 | ||
| 第203行: | 第204行: | ||
在 CelebA 人脸生成任务中,RealNVP 能够生成全局连贯、五官清晰的人脸样本(图 5)。与变分自编码器(Variational Autoencoder,VAE)相比,RealNVP 不依赖固定的重建损失(如均方误差(Mean Squared Error,MSE)),因此不会过度平滑高频细节;与 PixelRNN 等自回归模型相比,RealNVP 的采样在维度上完全并行,速度更快。 | 在 CelebA 人脸生成任务中,RealNVP 能够生成全局连贯、五官清晰的人脸样本(图 5)。与变分自编码器(Variational Autoencoder,VAE)相比,RealNVP 不依赖固定的重建损失(如均方误差(Mean Squared Error,MSE)),因此不会过度平滑高频细节;与 PixelRNN 等自回归模型相比,RealNVP 的采样在维度上完全并行,速度更快。 | ||
| | ||
| − | + | ||
| | ||
| + | [[文件:aeflow_anomaly_detection.png|缩略图|AE-FLOW 在胸部 X 光上的异常检测结果。左列为异常(肺炎)样本,右列为正常样本;自上而下依次为原图、重建图与残差图。引自 Zhao et al., 2023。|替代=|360x360px]] | ||
== 异常检测 == | == 异常检测 == | ||
| | ||
| 第213行: | 第215行: | ||
图 6 展示了 AE-FLOW 在胸部 X 光数据上的结果。左列为异常(肺炎)样本,右列为正常样本;每列自上而下依次为原图、重建图与残差图。正常样本的残差整体较暗,而异常样本的肺部区域出现明显亮斑,直观地反映了模型对异常模式的识别能力。 | 图 6 展示了 AE-FLOW 在胸部 X 光数据上的结果。左列为异常(肺炎)样本,右列为正常样本;每列自上而下依次为原图、重建图与残差图。正常样本的残差整体较暗,而异常样本的肺部区域出现明显亮斑,直观地反映了模型对异常模式的识别能力。 | ||
| | ||
| − | + | ||
| | ||
| | ||
| 第226行: | 第228行: | ||
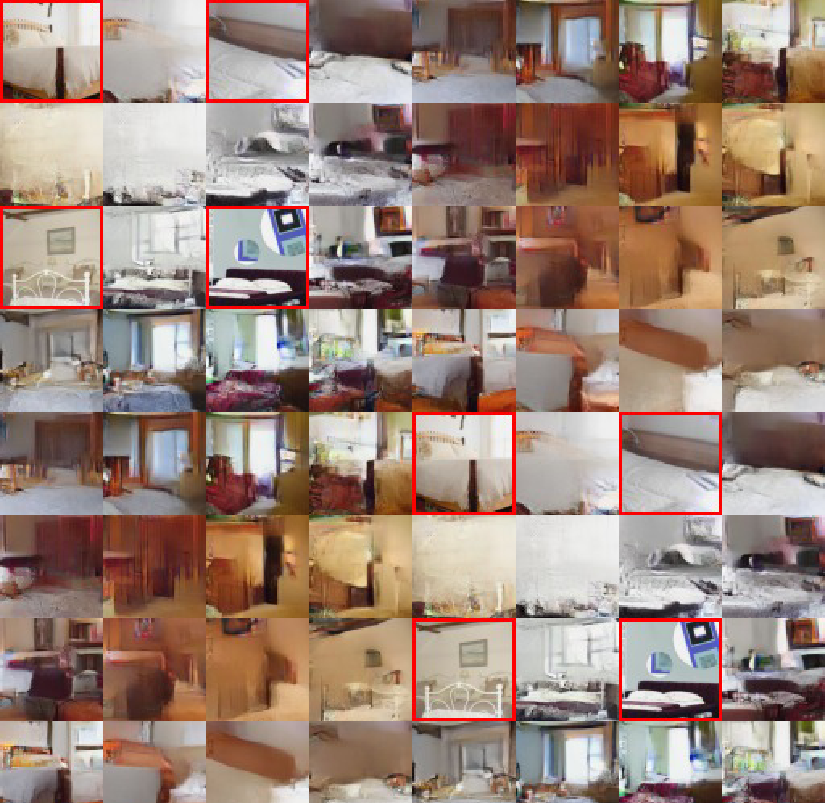
由于模型学习了全数据分布的精确密度,它能对任意形状的掩码产生合理的语义补全,而非仅记忆特定训练掩码。在 LSUN 卧室数据集上,RealNVP 对缺失区域(红框)的补全结果在语义和视觉上均保持合理(图 7)。 | 由于模型学习了全数据分布的精确密度,它能对任意形状的掩码产生合理的语义补全,而非仅记忆特定训练掩码。在 LSUN 卧室数据集上,RealNVP 对缺失区域(红框)的补全结果在语义和视觉上均保持合理(图 7)。 | ||
| | ||
| − | [[文件:realnvp_lsun_inpainting.png|缩略图|RealNVP 在 LSUN 卧室数据集上的图像修复结果:红框标出被遮挡的原始区域,模型仅根据剩余像素和全分布密度完成补全。引自 Dinh et al., 2017。| | + | [[文件:realnvp_lsun_inpainting.png|缩略图|RealNVP 在 LSUN 卧室数据集上的图像修复结果:红框标出被遮挡的原始区域,模型仅根据剩余像素和全分布密度完成补全。引自 Dinh et al., 2017。|274x274px|链接=Special:FilePath/Realnvp_lsun_inpainting.png]] |
| | ||
== 在 NIS/NIS+ 因果[[涌现]]框架中的应用 == | == 在 NIS/NIS+ 因果[[涌现]]框架中的应用 == | ||
2026年8月5日 (三) 20:24的版本
编辑“RealNVP” 跳到导航跳到搜索 未选择任何文件 高级 特殊字符 帮助 拖动文件至此
AI 一键智能添加链接 ⚙ RealNVP(Real-valued Non-Volume Preserving,实值非体积保持变换)是一类基于标准化流(normalizing flows)的深度生成模型,由 Laurent Dinh、Jascha Sohl-Dickstein 与 Samy Bengio 于 2017 年提出[1]。它的核心思想可以概括为:用一个完全可逆的神经网络,将复杂的数据分布逐步变换为简单的高斯分布。由于变换可逆,模型既可正向精确计算数据的概率密度,也可反向直接从高斯分布采样生成新数据。

原理概述
RealNVP 是一类标准化流:它将一系列可逆映射 [math]\displaystyle{ f_1, \dots, f_n }[/math] 复合为整体变换 [math]\displaystyle{ f = f_n \circ \cdots \circ f_1 }[/math],从而将数据 [math]\displaystyle{ \mathbf{x} }[/math] 映射到标准正态分布 [math]\displaystyle{ \mathbf{z} = f(\mathbf{x}) \sim \mathcal{N}(0, \mathbf{I}) }[/math]。由于可逆性,生成样本时只需从正态分布采样 [math]\displaystyle{ \mathbf{z} }[/math],再通过逆映射 [math]\displaystyle{ \mathbf{x} = f^{-1}(\mathbf{z}) }[/math] 还原为数据。每一层变换的雅可比行列式都能高效解析计算,因此整体对数似然 [math]\displaystyle{ \log p_X(\mathbf{x}) }[/math] 可直接求出,无需借助变分下界或对抗训练。
历史渊源
RealNVP 建立在早期标准化流工作之上,其发展有两条主线。 第一条主线是可逆变换的"分层堆叠"思想。从 1990 年代的独立成分分析(Independent Component Analysis,ICA),到 2000 年 Chen 与 Gopinath 的高斯化(Gaussianization)[2],研究者一直尝试用可逆变换将复杂数据"归一化"到简单分布。2010 年,Tabak 与 Vanden-Eijnden 正式提出了"标准化流"(normalizing flow)的数学框架——通过一系列可逆映射,让基分布像水流一样"流动"成目标分布[3]。 第二条主线是耦合层的发明与升级。2014 年,Dinh 等人提出了 NICE(Non-linear Independent Components Estimation,NICE),首次使深度可逆网络可训练[4]。NICE 的关键创新是加性耦合层:将输入分成两半,其中一半直接保持不变,另一半则加上一个以第一半为条件的神经网络输出。由于该变换的雅可比行列式恒为 1,它保持体积(volume preserving),但表达能力因此受限。 2017 年的 RealNVP 将加性耦合扩展为仿射耦合,即以前一半变量为条件,对后一半变量先进行缩放再进行平移。这一改动使变换不再保持体积(non-volume preserving),增强了模型的表达能力,同时保留了计算上的便利性。后续的理论工作(Draxler et al., 2024)证明:体积保持的流不是分布的普适逼近器,而仿射耦合流在良好条件下是[5]。这从理论上解释了 RealNVP 相对于 NICE 的优势。
算法框架

RealNVP 把若干可逆模块按顺序堆叠,形成从数据空间到潜在空间的完整映射。其网络主体由四个功能模块组成:仿射耦合层(affine coupling layer)负责可逆的特征变换,每个耦合层输出后接批量归一化(batch normalization)以稳定训练;压缩(squeeze)负责降低空间分辨率并把信息重排到通道;变量分解(factor out)负责在每个尺度末尾抽取一部分变量作为潜在编码。其中,仿射耦合层通过空间棋盘掩码(checkerboard masking)与通道级掩码(channel-wise masking)实现,二者交替使用。 图 4 给出了整体的多尺度架构。如图所示,输入图像 [math]\displaystyle{ \mathbf{x} }[/math] 首先进入第一层 Scale 1。每个非末尺度内部依次经过 3 个空间棋盘掩码的耦合层(每个耦合层输出后接批量归一化)、压缩块、再 3 个通道级掩码的耦合层(同样每个后接批量归一化),最后通过变量分解把当前特征一分为二;末尺度则只经过 4 个空间棋盘掩码耦合层(同样每个后接批量归一化)就进行变量分解。一半结果作为 [math]\displaystyle{ \mathbf{z}^{(i)} }[/math] 抽出,另一半 [math]\displaystyle{ \mathbf{h}^{(i)} }[/math] 继续传入下一尺度。不同尺度之间通过折线连接,最终把每个 [math]\displaystyle{ \mathbf{z}^{(i)} }[/math] 展平为向量后按顺序拼接成完整潜变量 [math]\displaystyle{ \mathbf{z} }[/math]。虽然各 [math]\displaystyle{ \mathbf{z}^{(i)} }[/math] 的展平长度不同(依次为 [math]\displaystyle{ HWC/2, HWC/4, \dots, HWC/2^{L-1} }[/math]),但它们的总和恰好等于输入维度 [math]\displaystyle{ HWC }[/math],因此整体变换保持维度不变。这种分层设计的意图是:早期尺度保留高分辨率的局部细节,后期尺度处理低分辨率的全局结构,并通过逐步分解减少后续层的计算量。 正向流程可概括为: [math]\displaystyle{ \mathbf{x} = \mathbf{h}^{(0)} \;\xrightarrow{\text{耦合层} \times n}\; \xrightarrow{\text{压缩}}\; \xrightarrow{\text{耦合层} \times n}\; \xrightarrow{\text{分解出一半}}\; \mathbf{z}^{(1)} \;\longrightarrow\; \cdots \;\longrightarrow\; \mathbf{z} }[/math] 由于每个压缩和分解步骤都要对空间或通道维度进行对半划分,各尺度的空间尺寸与通道数都必须是偶数;实际应用中通常把图像尺寸调整为偶数,或通过填充、裁剪等预处理满足该条件。
仿射耦合层:可逆的"条件变形"
图 2 给出了仿射耦合层的前向流程。图中的耦合层块即仿射耦合层,它是 RealNVP 的基本可逆变换单元。

-
[math]\displaystyle{ \begin{cases} \mathbf{y}_{1:d} = \mathbf{x}_{1:d} \\[6pt] \mathbf{y}_{d+1:D} = \mathbf{x}_{d+1:D} \odot \exp\!\bigl(\mathbf{s}(\mathbf{x}_{1:d})\bigr) + \mathbf{t}(\mathbf{x}_{1:d}) \end{cases} }[/math]
(1)
这里 [math]\displaystyle{ \mathbf{s} }[/math](scale,缩放)和 [math]\displaystyle{ \mathbf{t} }[/math](translation,平移)是两个深度神经网络(可以是任意结构,因为常用于图像相关的任务,所以人们通常用卷积神经网络(Convolutional Neural Network,CNN))。[math]\displaystyle{ \odot }[/math] 为逐元素乘积。由于 [math]\displaystyle{ \mathbf{s} }[/math] 和 [math]\displaystyle{ \mathbf{t} }[/math] 的输入只来自不变的那一半,输出只作用在可变的那一半,整个变换的雅可比矩阵是下三角块结构,行列式即为对角线元素的乘积——计算复杂度从 [math]\displaystyle{ O(D^3) }[/math] 降到 [math]\displaystyle{ O(D) }[/math]。此外,逆变换为:
-
[math]\displaystyle{ \begin{cases} \mathbf{x}_{1:d} = \mathbf{y}_{1:d} \\[6pt] \mathbf{x}_{d+1:D} = \bigl(\mathbf{y}_{d+1:D} - \mathbf{t}(\mathbf{y}_{1:d})\bigr) \odot \exp\!\bigl(-\mathbf{s}(\mathbf{y}_{1:d})\bigr) \end{cases} }[/math]
(2)
无需对 [math]\displaystyle{ \mathbf{s} }[/math] 或 [math]\displaystyle{ \mathbf{t} }[/math] 求逆,只需按公式 (2) 进行减法和除法即可。因此编码(求密度)和解码(采样)同样高效。
掩码卷积的两种分区模式
仿射耦合层要先把输入分成两部分。针对图像数据,RealNVP 使用两种掩码来决定划分方式:
- 空间棋盘掩码(checkerboard masking):像国际象棋棋盘一样,按坐标 [math]\displaystyle{ (i+j) }[/math] 的奇偶性决定像素是否属于"被动"集合。相邻像素被分到不同集合,能充分利用局部相关性。
- 通道级掩码(channel-wise masking):将前一半通道设为被动,后一半为主动。这通常在"压缩"操作后使用,因为此时空间分辨率已降低,通道间的语义分工更明确。
通过交替堆叠不同掩码的耦合层(至少三层),每个维度在不同层中分别作为被动变量和主动变量,信息得以充分混合。
多尺度架构:分层打包潜在变量
图 4 的多尺度架构依赖两个关键操作:压缩与变量分解。 压缩:将空间上每个 [math]\displaystyle{ 2\times2 }[/math] 的小块在通道方向上重排,将 [math]\displaystyle{ s\times s\times c }[/math] 重排为 [math]\displaystyle{ s/2 \times s/2 \times 4c }[/math]。空间分辨率减半,通道数四倍——信息被重新排列,但没有丢失。 变量分解:在每个尺度结束时,将当前表示的一半维度提取为潜在变量 [math]\displaystyle{ \mathbf{z}^{(i)} }[/math],剩下的一半 [math]\displaystyle{ \mathbf{h}^{(i)} }[/math] 继续进入下一尺度。最终所有 [math]\displaystyle{ \mathbf{z}^{(i)} }[/math] 展平后拼接成完整的潜在编码 [math]\displaystyle{ \mathbf{z} }[/math],其总维度与输入维度相等。 该设计具有以下优势:
- 层次化表示:早期提取的 [math]\displaystyle{ \mathbf{z} }[/math] 对应局部纹理(如边缘、颜色),后期提取的对应全局语义(如物体姿态、场景结构)。
- 梯度分散:损失信号能直接传递到所有尺度,避免梯度在深层消失。
- 降低计算负担:越早提取的维度越多,后续层需要处理的特征图越小。
批量归一化:训练深层的稳定器
批量归一化(Batch Normalization,BN)应用于每个耦合层的输出之后,用于稳定深层训练。 [math]\displaystyle{ \mathbf{x} \mapsto \frac{\mathbf{x} - \tilde{\boldsymbol{\mu}}}{\sqrt{\tilde{\boldsymbol{\sigma}}^2 + \epsilon}} }[/math] 它的雅可比行列式是各维度缩放因子的乘积,可直接加入对数似然。此外,BN 起到训练深耦合层堆叠时的稳定作用——它抑制了由缩放参数 [math]\displaystyle{ \exp(\mathbf{s}) }[/math] 引起的数值爆炸,使梯度稳定传播。
数学原理
标准化流与变量替换公式
标准化流的核心是概率论中的变量替换公式(change of variables)。设 [math]\displaystyle{ \mathbf{z} \sim p_Z(\mathbf{z}) }[/math] 是已知先验(通常取标准正态 [math]\displaystyle{ \mathcal{N}(0, \mathbf{I}) }[/math]),[math]\displaystyle{ f = g^{-1} }[/math] 是从数据 [math]\displaystyle{ \mathbf{x} }[/math] 到 [math]\displaystyle{ \mathbf{z} }[/math] 的可逆映射(编码器)。则 [math]\displaystyle{ \mathbf{x} }[/math] 的密度为:
-
[math]\displaystyle{ p_X(\mathbf{x}) = p_Z\!\bigl(f(\mathbf{x})\bigr)\;\left|\det\!\left(\frac{\partial f(\mathbf{x})}{\partial \mathbf{x}^\top}\right)\right| }[/math]
(3)
取对数得到训练用的目标:
-
[math]\displaystyle{ \log p_X(\mathbf{x}) = \log p_Z\!\bigl(f(\mathbf{x})\bigr) + \log\left|\det\!\left(\frac{\partial f(\mathbf{x})}{\partial \mathbf{x}^\top}\right)\right| }[/math]
(4)
上式中,第一项 [math]\displaystyle{ \log p_Z(f(\mathbf{x})) }[/math] 衡量编码后分布与标准高斯的接近程度;第二项(对数雅可比行列式)则是体积补偿项——如果 [math]\displaystyle{ f }[/math] 在某个局部使空间扩张([math]\displaystyle{ \det \gt 1 }[/math]),密度必须相应降低,反之亦然。当流由 [math]\displaystyle{ K }[/math] 个变换复合而成 [math]\displaystyle{ f = f_K \circ \cdots \circ f_1 }[/math] 时,总对数密度是各层对数行列式的求和: [math]\displaystyle{ \log p_X(\mathbf{x}) = \log p_Z\!\bigl(f(\mathbf{x})\bigr) + \sum_{k=1}^K \log\left|\det\!\left(\frac{\partial f_k}{\partial \mathbf{x}_k^\top}\right)\right| }[/math] 采样时通过逆向进行:[math]\displaystyle{ \mathbf{z} \sim p_Z }[/math],[math]\displaystyle{ \mathbf{x} = g(\mathbf{z}) = f_1^{-1} \circ \cdots \circ f_K^{-1}(\mathbf{z}) }[/math],每层内部运算可并行,因此整体采样速度高于自回归模型。
仿射耦合的雅可比行列式与可逆性
仿射耦合层对前 [math]\displaystyle{ d }[/math] 维进行恒等映射,对后 [math]\displaystyle{ D-d }[/math] 维进行仿射映射,因而雅可比矩阵具有分块三角结构: [math]\displaystyle{ \frac{\partial \mathbf{y}}{\partial \mathbf{x}^\top} = \begin{bmatrix} \mathbf{I}_d & \mathbf{0} \\[8pt] \dfrac{\partial \mathbf{y}_{d+1:D}}{\partial \mathbf{x}_{1:d}^\top} & \operatorname{diag}\!\bigl(\exp[\mathbf{s}(\mathbf{x}_{1:d})]\bigr) \end{bmatrix} }[/math] 由于左上角是单位阵,整个矩阵的行列式等于右下角对角阵的行列式:
-
[math]\displaystyle{ \det\!\left(\frac{\partial \mathbf{y}}{\partial \mathbf{x}^\top}\right) = \exp\!\left(\sum_{j=1}^{D-d} s_j(\mathbf{x}_{1:d})\right) }[/math]
(5)
上述性质是 RealNVP 可处理性的关键:计算行列式不需要对神经网络 [math]\displaystyle{ \mathbf{s} }[/math] 或 [math]\displaystyle{ \mathbf{t} }[/math] 求导。因此 [math]\displaystyle{ \mathbf{s} }[/math] 和 [math]\displaystyle{ \mathbf{t} }[/math] 可以是任意复杂的深度残差网络,而不会破坏密度评估的可处理性。多个耦合层复合时,行列式相乘、逆变换按相反顺序复合,性质仍然保持。 仿射耦合的逆变换为:对于公式 (1) 中的前向变换,经过代数变换即可得到公式 (2) 中的逆变换。无需对 [math]\displaystyle{ \mathbf{s} }[/math] 或 [math]\displaystyle{ \mathbf{t} }[/math] 求逆,只需按逆变换公式进行减法和除法即可。因此编码(求密度)和解码(采样)同样高效。
加性耦合、仿射耦合与体积保持
下表对比了三种耦合方式:
| 耦合类型 | 变换 | 雅可比行列式 | 体积行为 |
|---|---|---|---|
| 加性(NICE) | [math]\displaystyle{ \mathbf{y}_2 = \mathbf{x}_2 + \mathbf{t}(\mathbf{x}_1) }[/math] | [math]\displaystyle{ 1 }[/math] | 体积保持 |
| 乘法 | [math]\displaystyle{ \mathbf{y}_2 = \mathbf{x}_2 \odot \mathbf{s}(\mathbf{x}_1) }[/math] | [math]\displaystyle{ \prod s_j }[/math] | 非体积保持 |
| 仿射(RealNVP) | [math]\displaystyle{ \mathbf{y}_2 = \mathbf{x}_2 \odot \exp(\mathbf{s}(\mathbf{x}_1)) + \mathbf{t}(\mathbf{x}_1) }[/math] | [math]\displaystyle{ \prod \exp(s_j) }[/math] | 非体积保持 |
其中 [math]\displaystyle{ \odot }[/math] 为逐元素乘积,体现为空间的拉伸。NICE 的加性耦合对应于平移变换——只改变位置,不拉伸空间;RealNVP 的仿射耦合则允许缩放与平移的组合,更适合匹配真实数据中不同维度、不同尺度的变化。后续理论表明,缺乏这种"非体积保持"能力的流模型,在表达能力上存在本质限制[5]。
损失函数与最大似然训练
RealNVP 通过最大化数据对数似然来训练,等价于最小化数据分布与模型分布的前向 KL 散度(Kullback-Leibler divergence,KL):
-
[math]\displaystyle{ \mathcal{L}(\theta) = -\mathbb{E}_{p^*(\mathbf{x})}\left[\log p_Z\!\bigl(f(\mathbf{x})\bigr) + \log\left|\det\!\left(\frac{\partial f(\mathbf{x})}{\partial \mathbf{x}^\top}\right)\right|\right] }[/math]
(6)
对于训练集 [math]\displaystyle{ \{\mathbf{x}^{(i)}\}_{i=1}^N }[/math],使用蒙特卡洛近似: [math]\displaystyle{ \mathcal{L}(\theta) \approx -\frac{1}{N}\sum_{i=1}^N \left[\log p_Z\!\bigl(f(\mathbf{x}^{(i)})\bigr) + \sum_{k=1}^K \log\left|\det\!\left(\frac{\partial f_k}{\partial \mathbf{x}_k^\top}\right)\right|\right] }[/math] 损失函数包含两项:
- 先验项 [math]\displaystyle{ \log p_Z(f(\mathbf{x})) }[/math]:促使编码后的 [math]\displaystyle{ \mathbf{z} }[/math] 聚集在标准正态分布中心附近,相当于对潜在空间的正则化。
- 行列式项:促使模型在数据密集的区域扩张体积、在稀疏区域收缩体积——这与信息论中将码空间分配给高概率事件的原则一致。
从对偶视角看(Papamakarios et al., 2021)[6]:在数据上最小化前向 KL,等价于在潜在空间中最小化推前分布与先验之间的反向 KL。 实际训练配置:自适应矩估计(Adaptive Moment Estimation,Adam)优化器,权重衰减 [math]\displaystyle{ 5\times10^{-5} }[/math],批量大小 64,先验为标准高斯。图像数据通常先经 logit 变换 [math]\displaystyle{ \operatorname{logit}(\alpha + (1-\alpha)\mathbf{x}/256) }[/math] 处理,以消除像素边界的边界效应。
应用
自然图像密度估计与生成
RealNVP 最直接的应用场景是连续高维数据的密度估计与无条件生成。在图像生成任务中,模型一次性学习整个图像的联合分布,然后直接从标准高斯分布采样并通过逆映射得到新图像。由于采样过程不依赖逐像素的顺序解码,生成速度显著高于自回归模型。 在 CelebA 人脸生成任务中,RealNVP 能够生成全局连贯、五官清晰的人脸样本(图 5)。与变分自编码器(Variational Autoencoder,VAE)相比,RealNVP 不依赖固定的重建损失(如均方误差(Mean Squared Error,MSE)),因此不会过度平滑高频细节;与 PixelRNN 等自回归模型相比,RealNVP 的采样在维度上完全并行,速度更快。

异常检测
RealNVP 能够给出数据的精确似然,这使它天然适合无监督异常检测:在仅含正常样本的数据上训练流模型,测试时似然较低或重建误差较大的样本即被视为异常。医学影像领域尤其典型——正常扫描数量庞大,而病变样本稀少且难以标注。 AE-FLOW 将自编码器与以 RealNVP 仿射耦合层为核心的标准化流瓶颈相结合,在胸部 X 光、OCT、皮肤镜与脑部 MRI 等多种医学影像数据上检测异常。模型同时利用重建误差与流模型给出的负对数似然构造异常分数:正常样本能被准确重建并获得较高似然,而病变区域会产生高重建残差与低似然[7]。 图 6 展示了 AE-FLOW 在胸部 X 光数据上的结果。左列为异常(肺炎)样本,右列为正常样本;每列自上而下依次为原图、重建图与残差图。正常样本的残差整体较暗,而异常样本的肺部区域出现明显亮斑,直观地反映了模型对异常模式的识别能力。
重建设置中的推断
由于编码器 [math]\displaystyle{ f }[/math] 与解码器 [math]\displaystyle{ g }[/math] 互为逆映射([math]\displaystyle{ \mathbf{x} = g(f(\mathbf{x})) }[/math]),RealNVP 天然适合图像修复、去噪、着色等重建设置。以图像修复为例:已知像素 [math]\displaystyle{ \mathbf{x}_O }[/math] 固定,对缺失像素 [math]\displaystyle{ \mathbf{x}_H }[/math] 用梯度上升最大化 [math]\displaystyle{ \log p_X(\mathbf{x}_O, \mathbf{x}_H) }[/math],并加入少量高斯噪声扰动: [math]\displaystyle{ \mathbf{x}_{H}^{(t+1)} = \mathbf{x}_{H}^{(t)} + \alpha_t \left(\frac{\partial \log p_X(\mathbf{x}_O, \mathbf{x}_{H}^{(t)})}{\partial \mathbf{x}_H} + \boldsymbol{\epsilon}\right) }[/math] 由于模型学习了全数据分布的精确密度,它能对任意形状的掩码产生合理的语义补全,而非仅记忆特定训练掩码。在 LSUN 卧室数据集上,RealNVP 对缺失区域(红框)的补全结果在语义和视觉上均保持合理(图 7)。
在 NIS/NIS+ 因果涌现框架中的应用
在神经信息挤压器(Neural Information Squeezer,NIS)及其扩展 NIS+(Neural Information Squeezer Plus,NIS+)中,RealNVP 以可逆神经网络(Invertible Neural Networks,INN)作为编码器,实现微观状态到宏观状态的可逆粗粒化。粗粒化策略被建模为两阶段过程:
- 无损变换:由 RealNVP 耦合层堆叠构成的可逆神经网络(INN)[math]\displaystyle{ \psi_\alpha: \mathbb{R}^p \to \mathbb{R}^p }[/math] 将微观状态 [math]\displaystyle{ \mathbf{x}_t }[/math] 映射到等维潜在空间 [math]\displaystyle{ \mathbf{x}'_t }[/math]。该阶段信息不丢失。
- 信息丢弃:投影算子 [math]\displaystyle{ \chi_{p,q} }[/math] 丢弃 [math]\displaystyle{ p-q }[/math] 个维度,得到宏观状态 [math]\displaystyle{ \mathbf{y}_t = \chi_{p,q}(\psi_\alpha(\mathbf{x}_t)) }[/math]。
解码时,将宏观预测 [math]\displaystyle{ \hat{\mathbf{y}}_{t+1} }[/math] 与 [math]\displaystyle{ p-q }[/math] 维标准高斯噪声拼接,通过逆 INN [math]\displaystyle{ \psi_\alpha^{-1} }[/math] 重构微观状态。由于 RealNVP 的编码器与解码器只是方向反转,参数完全共享,模型参数量直接减半(图 8)。


NIS 论文给出选用 RealNVP 的三点依据[8]:
- 精确可逆性:微观到潜在的变换不损失信息,信息丢弃量 [math]\displaystyle{ p-q }[/math] 成为显式可控的超参数。
- 参数共享:[math]\displaystyle{ \psi_\alpha }[/math] 与 [math]\displaystyle{ \psi_\alpha^{-1} }[/math] 共用一套参数,显著压缩模型规模。
- 行列式可解析:三角雅可比结构使有效信息(Effective Information,EI)上界和最优宏观维度 [math]\displaystyle{ q }[/math] 的存在性等核心定理得以严格推导。
消融实验表明,若将 RealNVP 替换为普通前馈网络或 VAE,多步预测误差显著上升;在分布外泛化测试中,仅基于 RealNVP 的 NIS/NIS+ 保持了低误差。论文指出:可逆神经网络作为编码器和解码器是必需的。在 NIS+ 中,RealNVP 继续承担编码–解码功能,而 EI 最大化等改进发生在投影后的宏观动力学空间上,不改动 INN 模块本身[9]。
优缺点
优势
- 精确且可处理的对数似然:无需变分下界或对抗训练,直接给出数据的精确密度值,适用于异常检测、贝叶斯推断等需要显式概率的场景。
- 并行采样与推断:编码和解码均可在维度上完全并行,速度高于自回归模型。
- 语义潜在空间:同维度的潜在表示支持属性插值与操控,适合表示学习。
- 架构灵活:[math]\displaystyle{ \mathbf{s} }[/math] 和 [math]\displaystyle{ \mathbf{t} }[/math] 网络可使用任意深度卷积神经网络(Convolutional Neural Network,CNN)/残差网络(Residual Network,ResNet),表达能力不受耦合结构本身限制。
- 综合多种模型特性:兼具自回归模型的精确似然、VAE 的快速采样、以及不依赖固定重建损失的生成能力。
局限
- 似然性能未达最优:在 bits/dim 上仍略逊于 PixelRNN 等先进自回归基线。
- 维度保持约束:单层流无法降维,需通过多尺度架构的"分解"操作间接实现。
- 仿射耦合的表达力上限:相比后续 Flow++ 的 Logistic 混合 CDF 耦合、Neural Spline Flows 的有理二次样条耦合,仿射函数形式较简单[10]。
- 均匀去量化的次优性:对离散像素加均匀噪声的做法,后来被变分去量化改进。
- 分区固定性:掩码模式在训练前固定,Glow(Generative Flow with Invertible 1×1 Convolutions,Glow)的可逆 [math]\displaystyle{ 1\times1 }[/math] 卷积通过学习置换提供了更灵活的分区[11]。
与相关框架的关系
RealNVP 在标准化流的发展中处于承上启下的位置: 前驱工作
| 方法 | 年份 | 核心贡献 | 与 RealNVP 的关系 |
|---|---|---|---|
| NICE[4] | 2014 | 加性耦合层 | RealNVP 的直接前身,将加性耦合扩展为仿射耦合 |
| Rezende & Mohamed NFs[12] | 2015 | 标准化流术语 + 平面流/径向流 | 提供了变分推断中标准化流的理论框架 |
后继发展
| 方法 | 年份 | 核心创新 | 与 RealNVP 的对比 |
|---|---|---|---|
| MAF(Masked Autoregressive Flow,MAF)[13] | 2017 | 全自回归条件 | 密度评估更灵活,但采样需顺序进行 |
| Glow[11] | 2018 | 可逆 1×1 卷积 + actnorm | 刷新了图像生成基准 |
| FFJORD(Free-form Jacobian of Reversible Dynamics,FFJORD)[14] | 2019 | 连续时间流 + 常微分方程(Ordinary Differential Equation,ODE)描述 | 消除架构约束,但需数值积分 |
| Flow++[10] | 2019 | 变分去量化 + Logistic 混合 CDF 耦合 | 改进 RealNVP 在密度估计、去量化和耦合函数上的短板 |
| Residual Flows[15] | 2019 | 无偏行列式估计 | 将残差网络引入可逆建模 |
理论分析
- Draxler et al.(ICML 2024)[5]:证明耦合型标准化流(含 RealNVP)在良好条件下是分布普适的;体积保持流则不是,说明 NICE 存在理论局限。
署名
本词条由 黄一凡 编写。
- ↑ Dinh L.; Sohl-Dickstein J.; Bengio S. (2017). "Density Estimation Using Real NVP". International Conference on Learning Representations (ICLR).
- ↑ Chen S. S.; Gopinath R. A. (2000). Gaussianization. Advances in Neural Information Processing Systems (NIPS).
- ↑ Tabak E. G.; Vanden-Eijnden E. (2010). "Density Estimation by Dual Ascent of the Log-Likelihood". Communications in Mathematical Sciences. 8 (1): 217–233.
- ↑ 4.0 4.1 Dinh L.; Krueger D.; Bengio Y. (2014). "NICE: Non-linear Independent Components Estimation". ICLR 2015 Workshop.
- ↑ 5.0 5.1 5.2 Draxler F.; Wahl S.; Schnörr C.; Köthe U. (2024). "On the Universality of Volume-Preserving and Coupling-Based Normalizing Flows". Proceedings of the 41st International Conference on Machine Learning (ICML). PMLR 235.
- ↑ Papamakarios G.; Nalisnick E.; Rezende D. J.; Mohamed S.; Lakshminarayanan B. (2021). "Normalizing Flows for Probabilistic Modeling and Inference". Journal of Machine Learning Research. 22 (57): 1–64.
- ↑ Zhao Y.; Ding Q.; Zhang X. (2023). "AE-FLOW: Autoencoders with Normalizing Flows for Medical Images Anomaly Detection". International Conference on Learning Representations (ICLR).
- ↑ Zhang J.; Liu K. (2022). "Neural Information Squeezer for Causal Emergence". Entropy. 25 (1): 26.
- ↑ Yang M.; Wang Z.; Liu K.; Rong Y.; Yuan B.; Zhang J. (2025). "Finding Emergence in Data by Maximizing Effective Information". National Science Review. 12 (1): nwae279.
- ↑ 10.0 10.1 Ho J.; Chen X.; Srinivas A.; Duan Y.; Abbeel P. (2019). "Flow++: Improving Flow-Based Generative Models with Variational Dequantization and Architecture Design". ICML.
- ↑ 11.0 11.1 Kingma D. P.; Dhariwal P. (2018). "Glow: Generative Flow with Invertible 1×1 Convolutions". NeurIPS.
- ↑ Rezende D. J.; Mohamed S. (2015). "Variational Inference with Normalizing Flows". ICML.
- ↑ Papamakarios G.; Pavlakou T.; Murray I. (2017). "Masked Autoregressive Flow for Density Estimation". NIPS.
- ↑ Grathwohl W.; Chen R. T. Q.; Bettencourt J.; Sutskever I.; Duvenaud D. (2019). "FFJORD: Free-form Continuous Dynamics for Scalable Reversible Generative Models". ICLR.
- ↑ Chen R. T. Q.; Behrmann J.; Duvenaud D.; Jacobsen J.-H. (2019). "Residual Flows for Invertible Generative Modeling". NeurIPS.